📝 筆記
每一篇學習素材留下的觀念與技巧。新的在上面;每條都連回原本的段落。
46 站434 條更新於 2026-10-01 00:54
🔍
顯示 46 / 46 站按空白鍵或 Enter 加下一個條件;條件之間是 AND
沒有符合條件的站。

觀念
「把想法卸載到紙上」和「在紙上思考」的分界:寫的動作有沒有逼大腦做組織與處理
逐字抄、整齊存起來是把負荷卸到紙上(跑步跳上車);在紙上猜關係、重排、修正才是讓紙面扛記憶、大腦專心理解。
體悟
三條原則各反對一個本能壞習慣:wrong 反求正確、shorter 反求完整、again 反寫完就存
這樣對起來記,口訣就不只是口號,而是每次寫筆記時的三個自檢問題。
觀念
紙上的內容是暫時的工作狀態不是最終知識,所以弄清楚之前寫的連結只能是猜的
要求它正確等於要求自己在思考前就想完,紙面反而沒分擔任何負荷,於是陷入 analysis paralysis。
技巧
撒關鍵字時不排版、不分區;猜連結時用「大概、也許」把每條標成待驗證
一開始排整齊等於偷偷在做分類決定;不確定的口吻讓之後讀到相關內容時大腦自動去核對,這就是 priming 運作的方式。
技巧
對完美主義的警覺放在動筆之後:關鍵字撒到一半、開始想分組時才會發作
所以不是開始前的心理建設,而是那一刻提醒自己:不是在做傑作,只是在整理思緒。
體悟
筆記有思考用與查閱用兩種功能;把查閱外包給原始材料與 AI,筆記就只需要短
作者說 AI 讓 reference notes 過時,理解成「必要性大幅下降」比「完全不需要」穩:版權書、課堂口述、需精確引用時摘錄仍有價值。
觀念
筆記要短有兩個獨立理由:寫時濃縮逼你處理,看時關鍵字讓比對變快
研究的關鍵變因是「有沒有經過自己改寫整理」而非字數本身;不經處理的長筆記才是問題。fast / examine / guess 對別人無資訊量,對寫的人足以喚回整句。
觀念
猜測的價值不在猜對,而在製造「筆記與理解不一致」的訊號;沒猜過就沒東西可修
變亂和發現錯誤不是副作用,是方法故意製造的兩個觸發條件。作者的例子:explicit memory 按能否被意識到分,working / long-term 按保存時間分,分類軸混用才會重疊。
技巧
重整時從空白重畫而不是在舊圖上塗改,這樣每個詞都要重新決定放哪、跟誰連
局部修補只重新處理被改到的幾個點;整張重畫等於把猜連結的動作對全部內容再做一遍,這才是「重整強化記憶」的機制。太亂靠 re-arranging,有錯靠 re-grouping / re-connecting。
體悟
判斷筆記是垃圾桶還是工作區:寫完就不再回頭動它是垃圾桶,會回來重整就是工作區
「記憶垃圾桶」與「跑步跳上車」是同一件事:把感覺消掉但沒處理。
體悟
這支只處理「資訊進來時怎麼組織」,沒處理學什麼、怎麼測試會了、怎麼複習
會議情境的 make it again 發生在會議結束後那幾分鐘的重整;看完這支不代表學習系統已完整。
第 11 段 →
適用範圍與收尾
體悟
學習成效看留在腦裡多少,不是進到腦裡多少;讀更快只放大輸入,沒增加處理
留下量 = 讀入量 × 保留率。保留率低時,提高保留率(消化)的效益遠大於提高讀入量。
技巧
讀的時候先問「這是 PACER 哪一類」,再用該類專屬流程消化;分類是為了配對正確的處理動作
P procedural / A analogous / C conceptual / E evidence / R reference。
技巧
Procedural 資訊一讀進來就在真實情境練;沒時間練就換別的讀或停下,別當場硬背
程序性知識的本質是動作序列與情境判斷,背只留住文字,沒留住技能;一兩週後再練早忘光。
體悟
消費與消化必須平衡:消化排不進去就削減消費,而不是多讀(學習版的暴食)
「忘掉九成」只是方向性主張,作者沒給出處,不要當精確數字。
技巧
建立類比後要 critique:哪裡像、哪裡不像、何時失效、要不要換——產物是「有邊界標記的類比」
類比只在相似處有效;不找不相似處,會把錯誤知識一起接進來。
觀念
Conceptual 用 mapping:專家的知識是網路不是序列,逐頁摘要保留了書的順序、丟掉了網路
邊讀邊畫、邊加邊重組;A(類比)不是獨立一類,而是附著在 P 或 C 上的策略。
體悟
Evidence 與 Reference 的差別不在資訊長什麼樣,而在將來怎麼用:放進論證 vs 直接回想
兩者都是讀時 store、之後 rehearse;reference 用 flashcards + spaced repetition(Anki),evidence 用解題、寫、教的方式演練。讀的當下絕不反覆重讀。

觀念
大廠面試每關分開評分,任一關低分就整體不過——「強項很強」補不了「弱項太弱」;面試官比較的是同職級的一批人
所以投錯職級等於自己換到更嚴格的評分尺。錯誤「一再出現」代表準備策略系統性偏掉,不是運氣。
觀念
Box model、REST 之所以篩掉人:考的不是知識量,「做得出來」與「講得出來」是兩種能力,只有後者能被評分
補三四小時是把已經會的東西整理成能開口講的形狀,不是學新知識。REST 題多半是具體場景:這動作用哪個 verb、URL 怎麼設計、失敗回什麼狀態碼。
觀念
職級不是一對一:小公司 senior 衡量獨立完成度,大廠衡量影響半徑;投錯沒過不會降級錄取,只會直接拒絕——代價是整輪重來
mid 做完明確任務、senior 自己界定問題帶動跨團隊、staff 對組織技術方向負責。越高職級技術題比重越低、行為題越高。
技巧
行為題準備四到六個故事(主動超出份內、衝突、失敗、趕死線取捨),每個寫清楚「你」的動作與可量化結果——素材庫不是逐題答案
最常失分是講成團隊流水帳(通篇「我們」)或結果不可量化:「順利上線」vs「建置 40 分鐘壓到 9 分鐘、每天省兩小時」。
技巧
system design 照職級分配:實習 / junior 全給演算法、基本功、行為題;mid-level 保留一小塊建詞彙與一套講題順序
釐清需求 → 估流量 → 定介面 → 畫資料流 → 講瓶頸與取捨。設計題完全講不出結構會被記成「不知道自己寫的東西跑在什麼上面」,是能力印象問題。
技巧
習慣靠固定觸發點與極低啟動門檻:釘同一時間地點、前一晚決定做哪題、狀態差的日子「只讀一題解法」也算完成
斷掉的不是進度而是連續性。把時間切成「練新題」與「回顧舊題」,隔幾天重看卡住的題只回想解法骨架。習慣的敵人是無聊不是難度。
技巧
面試結束半小時內寫四件事:被問哪些題(含追問)、卡在哪一步、事後想到的更好答案、對方透露這團隊在意什麼
累積三四次會看出固定失分點,比再刷五十題有用。多投只有在每次都複盤時才提高機率,否則用同一份弱點重複撞牆。冷卻期從上一次面試起算。

技巧
80/20 的實作:按頻率或依賴關係排序,先學被最多東西依賴的那一小塊——不是隨意「只學一點」
英文最常用一千字覆蓋日常對話八成;做菜基礎技法可遷移。問「這領域裡最常被用到、其他東西都建立在它上面的是什麼」。
體悟
失敗會產生學習、成功不會:失敗是「預測與結果的落差」,才是可修正的訊號;「盡快失敗」真正的意思是盡快拿到修正訊號
成功只告訴你「這次可以」,不告訴你哪裡是邊界。要的是小而快的失敗(投籃不進、講到一半卡住),不是高代價的失敗。
觀念
active recall 有效是因為闔書自問自答強迫做一次「預測」,卡住處就是落差暴露的位置;重讀課本永遠不會卡住,所以永遠拿不到訊號
觀念
集中比分散有效率的機制:技能要跨過門檻(重複到形成習慣),分散時每項都停在門檻下練完就忘;過門檻的技能自動化後不再佔容量
「學慢」不是降低速度,是縮小每一輪的範圍讓每輪都真的留下東西。跟「盡快失敗」不衝突:全部的失敗集中在同一個子技能上。
體悟
growth mindset 是「盡快失敗」的前提不是加分項:相信能力固定,每次失敗都在證明「我不行」,你會逃避失敗,學習循環就停了
「妄想程度的自信」要的是對「最終能搞懂」的信心,不是對「現在就會」的錯覺——後者反而讓你跳過反思。immersion 是 active recall 的低成本版,用空檔多跑幾輪循環。

觀念
queue 與 streaming 的本質差異是「訊息被消費後還在不在」:queue ack 後消失,streaming 留在 log 上
這正是後面「兩種 ack 方式」的根源。中間層解的是 N×M 義大利麵:producer 與 consumer 互不認識、只約定 channel。
觀念
Kafka 的 broker 同時處理訊息又存本機磁碟,所以加 broker 必須搬資料(rebalancing 數小時)
「處理能力」和「資料在哪」綁在同一台,擴充其中一個必然牽動另一個——compute / storage 分離就是把兩者拆開。
觀念
分離後:加 broker 立即上線沒東西要複製、加 bookie 立即接新寫入——舊資料留原處不會自動平均,但寫入壓力永遠在新資料上
broker 是交通指揮(stateless),BookKeeper 是獨立的分散式 write-ahead log 服務,預設三份複本。
觀念
一個 topic 的資料 = 一串 ledger,每個 ledger 各自選一組 bookie——加 bookie 不用 reshuffle 的實作原因
ZooKeeper(或 etcd / Oxia)是協調大腦:哪個 broker 擁有哪個 topic、ledger 在哪些 bookie。三個角色各自獨立擴展。
第 6 段 →
協調層、ledger 分段與 tiered storage
·
Ledger(segment) Tiered storage Apache ZooKeeper / Metadata store
觀念
百萬 topic 可能是因為 topic 資料是 ledger 分段而非每 topic 一個實體檔案——解鎖「每個使用者/裝置一個專屬 topic」的設計
不必把大家塞進幾個共享 channel 再過濾。Netdata 每個 agent 一個 topic 就是這用法。geo-replication 能 client failover 是因為 broker 無狀態、資料在儲存層有複本。
觀念
messaging 與 streaming 合一的具體實現:差別只在 consumer 怎麼 ack(逐筆 vs 累積),同一 topic 支援兩種
Kafka 有 ACL 與 quota,但沒有 tenant/namespace 這種一等結構,隔離要靠命名慣例拼湊。
觀念
「複製到多個 bookie 且落盤後才 ack」比 Kafka 預設(acks 可設、fsync 延後)更強,代價是寫入延遲略高——金融類採用主因
producer 收到 ack 那一刻資料已在多台機器的磁碟上。topic 便宜到可以每個請求路徑一個,所以能做 RPC over topics。
體悟
選型要補的功課:Pulsar 要 broker + bookie + metadata store 三種元件,運維比 Kafka 多;Kafka 生態更成熟

觀念
崩潰的 server 送不出 Close 幀與 FIN,client 的 socket 看起來「還開著」;TCP keepalive 兩小時才起作用
所以只能由 client 定期去探。這裡的 ping/pong 是應用層自訂訊息,瀏覽器 JS API 沒暴露協定層的 ping。
技巧
重連前先 fetch /health-check 探 server 活了沒,成功才 connectWebSocket——比盲目重開 socket 省資源
斷線期間把更新存 localStorage 重連後補送,只保證不遺失、不保證順序與不重複。server 收到任何訊息就回 pong 沒檢查內容,真實應用要區分。
體悟
heartbeat 偵測的是「server 沒以我預期的方式回應」不只是斷線:server 活著但邏輯壞掉也會被當死掉而無盡重連
把 pong 改成 pongo 就能不殺 server 驗證重連。重連解決不了邏輯錯誤,只會一直循環。
觀念
ping 每 5 秒、等 pong 門檻 10 秒 = 連續錯過兩次才重連;2:1 的比例讓單次網路抖動不會誤判
觀念
SSE 適合當備援因為它就是一個永不結束的 HTTP GET:WebSocket 被擋或 Upgrade 交握失敗時它通常還能通
server 整台死掉 SSE 一樣連不上——備援只是換一種方式失敗。EventSource 內建自動重連 + Last-Event-ID 續傳,是 WebSocket 沒有的。下行 SSE、上行 POST 是正常組合。
觀念
在 onerror 裡自己 close 再 setTimeout 重連,會蓋掉 EventSource 內建的自動重連與 Last-Event-ID 續傳
好處是跟 WebSocket 共用同一個 RECONNECT_INTERVAL。「WebSocket is closed before the connection is established」是重連太快的競態,暗示要退避與狀態檢查。
觀念
WebSocket 用 least_conn 不用 round robin:長連線一開幾小時,round robin 只看請求數,久了一台累積一堆長連線
proxy_http_version 1.1 + Upgrade / Connection 標頭不是裝飾:nginx 預設 1.0 且不轉 hop-by-hop 標頭。client 只認 LB 的 URL 所以 reconnect 邏輯完全不用改。
觀念
nginx 的 ip_hash 完全不用 cookie:拿 IP 前三 octet 做 hash,弱點是同一 NAT 後全打同一台、換網路就換台
靠 cookie 的黏性是另一套機制(hash $cookie_xxx 或 NGINX Plus sticky cookie)。要回同一台是因為 WebSocket server 有狀態:連線物件、訂閱、未送完訊息。
觀念
sticky session 只是「盡量」送回同一台,那台真的死了還是會被分到別台,server 端狀態一樣丟——它不解決這個問題
技巧
多台 server consume 同一個具名 queue 是工作佇列(輪流收);要廣播要用 fanout exchange + 每台專屬 queue
照影片畫面直接抄會得到「一半的 client 收不到」。broker 把 N×N 互連變 N×1,新 server 連上 broker 就自動加入廣播,代價是多一跳毫秒級延遲。
觀念
Vapor 是 compilation strategy 不是新 API:改的是同一份 template 被編譯成什麼 JS——原始碼是輸入,輸入不變輸出換一套
所以「不用改程式碼」是設計的直接後果不是行銷。靈感來自 Solid JS:從第一天就沒有 virtual DOM。
觀念
Vue 從來不是「有東西變就全部重畫」:track 讓它知道「哪個元件該重畫」,只是還不知道「元件裡的哪一塊」——知道一半
render function 執行時記錄讀到哪些 reactive data,只有那些變動才 trigger。這個「知道一半」是整條推理的關鍵。
觀念
static hoisting 省的是「重建 virtual node 物件與比對它」的成本,不是真實 DOM 元素——省的一直是分身那一側
編譯器把 template 分成「死的」與「活的」,樹在編譯那一刻就塗好顏色。patch flag、block tree 同一套路:把編譯期看出來的事實編進輸出。
體悟
如果編譯期早就知道哪個資料影響哪個 DOM 節點,diff 就是在重算一個已知的答案——不只不用 diff,連樹都不需要
mount 仍要走一次,被拿掉的是之後每次更新的中介。省的不只 diff 的 CPU,還有短命 v-node 的配置與回收(記憶體那半句的出處)。
觀念
做得到不需要新技術,只需換訂閱粒度:從「整個元件的 render function」縮小到「單一 DOM 節點」——同一套 reactivity
watch([myDep], () => { node.nodeValue = myDep.value })。最硬的工程問題是那個 node 參照從哪來:編譯器要替每個會變的位置產生穩定參照。
觀念
Vapor 輸出用 t0() clone 模板、靠 firstChild / nextSibling 走出節點參照;_renderEffect 直接寫文字
vdom 輸出裡 v-if 為 false 仍留註解節點佔位(diff 位置要對得上);512 NEED_PATCH 這些數字是編譯器留給 runtime 的提示。_delegate 把事件委派到祖先省記憶體。
體悟
「整個 app 都是 Vapor 才能移除 vdom runtime」是極硬的條件:任一個第三方元件庫就讓好處消失——把它當針對熱點的局部工具
實際收益來自大型清單、頻繁更新的表格。opt-in 的代價是兩條 runtime 並存,最易出問題的是模式交界(slot、provide/inject、transition)。只支援 Composition API 是模型衝突不是任性。

體悟
「不夠 senior」是具體的判斷:面試官在聽你有沒有把開放問題先切開再回答——junior 給結論,senior 給結構加取捨
在什麼條件下用、代價是什麼、不用會怎樣。前端基礎、系統設計、AI 輔助是同一個能力在三個尺度的展現:說得出「為什麼」。
第 1 段 →
開場:被拒的理由是「不夠 senior」
觀念
不是所有 transition 都繞過 reflow:只有 transform 與 opacity 可合成;動 width 照樣 layout
規則是看你動的是哪個屬性,不是看用 transition 還是 JS。layer promotion 吃 GPU 記憶體,will-change 短暫開啟動畫結束就拿掉。
觀念
single record principle 在 AI 時代特別容易違反:模型一段段產生,每個元件局部合理,同一筆資料被複製三處各有更新路徑
bug 不在寫的時候出現,而在其中一份忘了更新時。programming to interfaces 在前端 = 先決定 props 形狀再讓 AI 填實作。
技巧
只細看爆炸半徑大的改動(全域設定、測試、linter、type checker、package.json);把這些路徑列進 CODEOWNERS,不靠自己記得
體悟
static 檢查優先是因為成本固定(CI 幾十秒),dynamic 隨程式碼量線性成長——AI 每天產數百行時任何隨量成長的成本都會失控
三層遞進:TypeScript → linter(Oxlint)→ complexity 與 duplication。AI 的重複常是結構同字面不同,要 token / AST 級比對(jscpd)。檔案再肥靜態也會過,看檔案長度。
觀念
覆蓋率量的是「這行被執行到」不是「行為被驗證」;AI 易寫出跑過所有分支卻無意義斷言的測試——用 mutation testing 驗證測試本身
65% 以上、別衝過 85%:過高往往是沒人驗證過的假覆蓋率。AAA 骨架直接交代給 AI。
觀念
測試的價值 ≈ 訊號定位精度 ÷ 維護成本;e2e 掛掉只說系統壞了不說哪裡壞,要用時間或 token 去搜——「只寫 e2e」是最貴的除錯入口
體悟
token 成本的槓桿不在讓模型少講話,在「做一個功能要改動多少程式碼」——新問題翻譯回老問題:模組化與解耦
prompt caching 讓「穩定的放前面、變動的放後面」與檔案結構穩定有金錢價值。換成 GPU 時間計價結論不變。micro-frontend 判準是同時改同一份程式碼的人數。
觀念
box-sizing 只在你指定尺寸時才有意義;AI 愛硬寫 width: 300px,桌機好看手機爆掉再用 breakpoint 補洞
預設 content-box 的 padding/border 往外加;幾乎所有專案寫 * { box-sizing: border-box }。margin collapsing 只在垂直、父子間無 padding/border/BFC 時發生。
觀念
specificity 不是加總是逐位比大小;完整順序:origin → cascade layers → specificity → 出現順序
所以 !important 在更前面的關卡就分勝負;@layer 生效時低分規則可能贏。:where() 一律 0 分、:is() 取最高——設計系統靠這寫容易被覆寫的預設。
觀念
media query 問「視窗多寬」,可重用元件在意「容器多寬」——@container 讓元件自我響應
「永遠不用 px」太滿:border 寬度與圖示用 px 反而對。會隨使用者設定或容器改變的才用相對單位。rem 相對 root、em 相對父層。
觀念
依變動頻率切 bundle 才能分開快取:vendor 長壽 chunk + 內容雜湊檔名 immutable
你怎麼切 bundle 決定能不能分開快取。HTML 不快取、帶雜湊資產 max-age=31536000。邊緣讀寫分離的痛:使用者看不到自己剛寫的——讀自己的寫入或樂觀更新。

觀念
三個指標是把使用者感受拆成三個互不重疊的面向:看得到(LCP)、按得動(FID / INP)、不亂跳(CLS)
Google 挑的是「與跳出率相關性最高、且開發者改得動」的三件事。先建立量測的語言,再拿工具。
技巧
瀑布圖的「寬」有兩種:單一資源真的大(長深色條)、或前面排太多東西等待被拉長(淺色段是排隊)——決定壓檔案還是減請求
Amazon 行動版 333 個請求、大多是 479 B 的 beacon,每個都快卻靠數量把連線數吃光。找 LCP 元素比看整張瀑布圖更快。
技巧
LCP 三問同一件事:小一點(壓縮、webp)、近一點(CDN)、早一點(preload);預設 CSS 才是最典型的 render blocking
瀏覽器沒解析完 CSSOM 就不畫任何東西,「關鍵 CSS 內嵌、其餘非同步」通常比動 JS 更快見效。SPA 初次載入要先跑一堆 JS 才畫得出主要內容。
觀念
preload 的 as 不是裝飾:少了瀏覽器不知道優先權、還可能重複下載;LCP 主圖用 fetchpriority="high" 比 preload 直接
preload 是「提早發現」不是「提早畫出」,濫用讓所有東西都高優先權等於沒有優先權。
觀念
阻擋互動的只有主執行緒被佔住,兇手是長任務(> 50ms);三種手段對應三個時機:搬走(worker)、延後(lazy)、省掉(Qwik)
有效做法是把大工作切小、中間主動讓出主執行緒(scheduler.yield / setTimeout 切片)。判定用真實使用者第 75 百分位,你自己點一次快不算。FID 已被 INP 取代。
觀念
aspect-ratio 修的不是圖片是版面預留——同樣技巧適用任何「內容晚到」的區塊:廣告位、嵌入影片、非同步橫幅
width/height 屬性只拿來算長寬比,搭 width:100%; height:auto 沒衝突。使用者互動後 500ms 內的位移豁免。動畫只動 transform 與 opacity。
技巧
LCP 拆四項就是診斷書:TTFB 佔大宗 → 伺服器;element render delay 佔大宗 → 卡的是 render blocking,壓圖沒用
Web Vitals 擴充套件在正常瀏覽時就收數據、直接印出 LCP element 與造成位移的 DOM 元素。它是定位問題的工具不是驗收成績的(單次觀測 vs p75)。
第 6 段 →
Web Vitals 擴充套件:單頁診斷
·
Web Vitals Chrome extension Time to First Byte (TTFB) element render delay
技巧
整站掃描的價值是「發現你不知道自己有問題的頁面」;接進 CI 設分數門檻,PR 掉到門檻以下就擋——效能才變流程不是一次性活動
npx unlighthouse --site <url>,自動爬路由平行跑 Lighthouse。不同站路由數差四倍、預設模擬行動裝置節流,數字只當相對參考。
觀念
資深工程師交出解法,架構師交出限制;限制的價值是把「每次都要重新決定」變成「大部分情況不用決定」
一次決定會被重複套用幾百次——所以決定變少但影響更多人,錯誤也同樣被重複幾百次且發現得晚。要的不是不參與,是不當瓶頸。
觀念
微服務真正的計價單位不是服務數量,是跨服務呼叫的比例:比例低拆分是對的,比例高你只是把方法呼叫換成網路呼叫
三種代價:營運(復原 15 → 90 分鐘)、設計(40% 操作跨服務 = 邊界切錯)、機會成本(18 個月)。架構 = 帶著後果的 trade-off 記帳。
技巧
別問「這在技術上比較好嗎」,問「對什麼比較好」(擴展、部署、招人、除錯、值班的人)——再接著問「我們現在最缺哪一個」
五個選項彼此會打架:對擴展好的通常對除錯差。「被 call 起來的團隊」是唯一不會出現在架構圖上的成本。
觀念
組織影響力 = 同一個結論你自己能從成本、風險、價值、工程現實四個角度論證;每個角色都有否決權,所以不能只挑一種
翻譯機是把 A 的話轉述給 B,影響力是在任何會議裡你都是提案的人。成本給財務、風險給營運法遵、價值給產品、工程現實給工程師。
技巧
實際算那筆帳:多花 120 萬、生產力價值 100 萬,淨 -20 萬——business case 要有時間軸與敏感度,單年靜態比較得不出結論
攤開後要嘛找沒計入的價值(上市時間、故障成本),要嘛承認這一年不該做。8 → 5.5 FTE 在財務眼中是省人力,在工程眼中是裁員訊號。
觀念
大泥球不是有人偷懶,是沒有邊界時每個人的理性選擇加總;要改的不是耦合,是讓「直接動別人程式」成為最省事選項的條件
10 人時知識裝得進一場對話;80 人溝通路徑平方成長。六個動作裡最易略過的是遷移路徑與防止 recouple——只做前四項得到漂亮文件加沒變的程式庫。
觀念
遷移路徑本身就是架構:每一步能獨立產生價值、獨立回退(strangler fig);Netflix 三個前置元件是「遷移期間不停」的實作
service discovery 讓新舊並存能互找、API gateway 決定流量往哪走、circuit breaker 不讓失敗擴散。只有目標架構圖的是牆上的裝飾畫。
技巧
三條規則:提解法前先寫 trade-off;跟別的團隊爭論前先翻成成本風險價值;第五次修同一耦合前先問什麼結構在重製它
第三條需要觸發機制:在 issue/PR 標記受影響模組,每季看哪個交界處最常出現。寫下 trade-off 會逼出你其實沒想清楚的部分。
體悟
真正的落差在回饋週期:程式以秒計,架構以季年計且只在變糟時收到——要人為造中間指標,否則第二年會退回去寫程式
跨團隊協調次數、同類問題重複率、新人第一次上線天數——給自己看的儀表板。要放下的是把程式當價值來源的習慣,不是讀程式的能力。

技巧
效能除錯順序由內而外:元件層(re-render)→ 狀態層(結構、prop drilling)→ 載入層(dynamic import)→ bundle
判定「不必要的 re-render」= 重畫了卻沒改任何像素(DevTools Profiler highlight updates)。memo 有比較成本,先修 state 結構通常比到處包 memo 有效。
觀念
diffing 的兩個假設是 re-render 問題的根源:不同型別整棵重建不往下比;同層子元素靠 key 配對——沒 key 或用 index 會出錯
virtual DOM 用便宜的 JS 物件比對換掉昂貴的 DOM 寫入。memo 是在 reconciliation 之前就剪掉一整棵子樹。
觀念
paint 之後還有 compositing:改 width 回 layout、改 background 從 paint、改 transform 只動合成
這是「動畫用 transform 不要用 top/left」的來源。外部 CSS 是 render-blocking,沒 defer 的 script 擋住 HTML 解析。
技巧
debounce vs throttle 的判準:中間過程的結果有沒有用?搜尋建議只要最後一次 → debounce;捲動、拖曳要即時反饋 → throttle
按鈕防連點需要 leading(立刻執行第一次、後續忽略),debounce 預設是 trailing。
觀念
useRef 更新是同步立即可見的,useState 是排程的;「要立刻讀到最新值且不影響畫面」的東西放 ref:計時器 id、上一次的值、DOM 節點
硬規則:ref 的改變不會通知 React,任何要顯示在畫面上的東西不能只放 ref。
觀念
useEffect 不是 lifecycle 的一對一替代:思考從「哪個時間點做什麼」換成「跟哪些值同步」;依賴陣列是宣告不是效能開關
漏填造成 stale closure。是 componentWillUnmount 不是 DidUnmount——卸載後沒有實例可呼叫。StrictMode 刻意掛載兩次逼出沒清理的 effect。
觀念
SSR 改善的是「看得到」不是「用得動」(要等 hydration);決策:不變 SSG、可容忍延遲 ISR、每次最新或跟身分有關才 SSR
電商商品列表最常用 ISR,比 SSR 便宜得多。SEO 真正的價值:Google 排隊渲染 JS 會延遲索引,社群平台爬蟲多半不執行 JS。
觀念
error boundary 只攔 render 階段錯誤,事件處理器、setTimeout、非同步一律接不到;實務用 react-error-boundary
需要 getDerivedStateFromError(顯示 fallback)+ componentDidCatch(記錄)。Next.js 的 error.tsx 就是綁定路由層級的 boundary。
觀念
setInterval 的 id 存在 effect 的 closure 裡,re-render 後沒人握著它——這就是該放 ref 的值
clearInterval 收到不存在的 id 只會靜靜什麼都不做,所以這類 bug 難找。受試者對 useRef 的記憶只有「取 DOM」這個用例,而不是「跨 render 不變的容器」。
技巧
「你可能不需要 effect」判準:這件事是回應使用者操作發生的嗎?是就寫在事件處理器裡;只有跟外部系統同步才用 effect
Rules of Hooks:hook 只能在元件或自訂 hook 頂層,useEffect 的 callback 是巢狀函式。React 靠呼叫順序對應 hook 狀態。
體悟
ref 同時是計時器 id 保管處和「有沒有在跑」的單一真相:stop 設回 null、start 前檢查 ref.current
debounce 錯(隔十秒點兩次仍開兩個 interval)、hasStarted 錯(平行真相來源)、useCallback 無關。TypeScript 的 Timeout not assignable to null 就是線索。
體悟
知道一個 API 的定義,和知道它在具體問題裡該承擔什麼角色,中間的距離正是資深面試在量的
受試者第 7 段正確說出「useRef 記住跨 re-render 的值」,拿到「把 interval 存進 ref」的明示提示,仍需逐行帶著走。

體悟
這五個坑在絕大多數情況下行為都是對的,只在某個條件成立時才偏離直覺——要記的是五個「觸發條件」不是用法
來源會不會 complete、時間間隔對不對得上、比的是不是同一個物件、有沒有人還在訂閱。測試環境好好的、上線偶爾出事的那種錯。
觀念
bufferCount「不丟值」掛在來源會 complete 這個前提上:Subject 不會結束,湊不滿一批的值永遠卡住
「先初始化、再持續追加」的資料流同時具備兩個觸發條件:初始筆數不被批次大小整除、來源不結束。實務上加逾時或手動 flush 讓「湊不滿」有出路。
觀念
throttleTime 丟掉哪些值取決於來源間隔與 throttle 間隔的相對關係:接近整數倍時位置規律,互質時位置飄移
預設 leading edge:第 0 個立刻放行然後關窗。interval(100) + throttleTime(120) 穩定隔一個放一個。飄移正是最後值被吃的溫床。
技巧
throttle 可能吃掉最後一個值,而且「有時會有時不會」:窗口從上一個放行值起算,跟來源沒有協調;最終狀態改到 completion handler 處理
重現不了、寫不出穩定測試、看起來像別人的問題——最難查的一種 bug。
觀念
distinctUntilChanged 預設用 ===,比物件參照不比內容:經過 map、JSON 解析、任何產生新物件的更新就完全失效且無錯誤
反過來就地 mutation 同一個物件又會判定相等而擋掉真正的變更——同一機制的另一半災情,更難察覺。
體悟
第一次出現「operator 的預設行為可以被你接管」:傳 comparator (prev, curr);這觀念在 share 家族被推到極致
前兩個坑給的都是繞路,這次是直接把旋鈕轉過來。參數順序是 (previous, current),不對稱的比較邏輯順序不能寫錯。
觀念
cold observable 是「執行藍圖」:每次 subscribe 重跑一次含 tap、HTTP、計時器;share 是在中間插一個 Subject 多播
加上 share 後兩個訂閱收到的數字同步(都 0、都 1),cold 版本各自從 0 開始數。
觀念
of(1) 是同步的:第一個 subscribe 還沒執行完,值就送出、complete、解除了,refCount 歸零重置——兩個訂閱在時間上根本沒重疊
真實 HTTP(非同步)通常不會踩到:第二個訂閱在回應前就建好。用假資料測出事、換真 API 又好了。share 重置條件不只 refCount 歸零,complete 本身也會(resetOnComplete)。
觀念
share 與 shareReplay 對「什麼時候該放手」有相反預設:前者遇立刻完成的來源過度重置,後者遇永不完成的來源完全不重置
shareReplay 沒人訂閱還繼續跑 = 記憶體洩漏:來源仍持訂閱、計時器仍排程、緩衝區握著值;隨元件開關累積成殭屍串流。
技巧
自訂 shareWhileSubscribed:ReplaySubject 當 connector,只在 refCount 歸零時重置
每個重置條件獨立表態:ReplaySubject 換來記憶、refCountZero 為 true 沒人時停、resetOnComplete false 解 of() 那個坑、resetOnError false 不重打失敗請求。九成五情境。

體悟
面試腦袋一片空白的真因是「缺少心智里程碑」:不知道自己在哪、還缺什麼、下一步去哪;路線比任何單項技術值錢
路線:需求 → 狀態 → 實作 → 非功能需求 → AI 工具鏈。不能用電腦時你唯一能依賴的就是腦中那條路線。
技巧
非功能需求「先掛號、不展開」:無障礙與安全開頭提一句,讓面試官知道雷達上有,也替自己預留後面可回來深挖的話題
只有效能能給真正的數字(SLO、Core Web Vitals + RUM);無障礙與安全改用「有沒有法規」逼出標準。先切「初始載入 vs 持續刷新」。
技巧
用刪去法從 UI 圈狀態:對每一塊做明確判斷(範圍外/靜態/動態);兩個元素總能從同一份資料算出來就只該有一份
列舉法只會寫下你想得到的。「不在範圍」要跟面試官達成共識並說出口。current price 跟折線末端是同一個值。
觀念
AI 設計狀態不算幻覺而是「傾向膨脹」:會自己加不必要的細節、分不出畫面上哪些是靜態的——你要夠好才用得動它
它產出的是 DB schema 而不是前端狀態型別。正確用法是把 AI 當成會提出你沒想到選項的同事(decimal(18,2) 反而更貼近金融精度),由你來砍。
技巧
前端改變狀態只有兩個來源:後端送資料、使用者做事——想不出屬於哪類的變數,八成是衍生狀態
start/end 是查詢參數,data/loading/error 是查詢結果——因果不是並列。把 [start, end] 當 queryKey,其餘由 TanStack 托管,你一份狀態都不用寫。
體悟
Prettier 從品味問題變成 review 的可行性問題:六千行 agent PR 唯有格式一致,diff 才小到 review 得動
你不是在管束人類,是在替模型設定窄的輸出空間。靜態品質要靠 CI 閘門強制,否則 agent 會繞過。
技巧
junior 丟一句「code splitting」就沒了;senior 先攤三個維度(LCP、INP、CLS)逐一問各有多重要,再選手段
先問使用情境(公開?SEO?流量?):公開頁面在意首屏,登入後儀表板在意互動延遲。SSR 與 hydration 之間「看得到但按不動」的空窗是 INP 在抓的。
觀念
BFF 的判準:資料形狀落差多大、服務是不是自己擁有會不會常改;穩定介面讓 agent 大規模根因分析可行——跟 Prettier 同一招
反方向:形狀貼合且服務自己擁有時,多一層只是多一個要部署、監控、on-call 的東西。另兩個好處:金鑰留伺服器端、多次下游收斂成一次。
技巧
即時更新一刀砍:通訊是不是真的雙向?不是就 SSE;畫面上同時動的東西全能從一個新資料點加「進頁面時的基準」算出來
規則:能從「一份基準」加「當前值」算出來就只存這兩個。SSE 在 HTTP/1.1 每網域 6 條連線,一頁十個圖表要共用一條連線帶 asset id 分流或走 HTTP/2。
觀念
快取用時間軸切:過去唯讀(immutable 積極快取)、未來不可快取;請求依區間邊界對齊,URL 本身就決定它是不是已完結
否則每個使用者 URL 都不一樣,共用快取形同虛設。設計系統 CSS 比應用穩定,值得從 bundle 拆出獨立快取。HTTP 快取與 TanStack 快取是兩層互補。
體悟
模型缺乏視覺智能,所以要準備穩定錨點(設計系統、狀態圖、循序圖)讓它只做內插——這條面試路線產出的正好就是那組錨點
系統設計不是「AI 會寫程式後就不用學」,反而是 AI 時代唯一要親自產出的東西。審查代理與 coding agent 互修要大量監督,否則無窮迴圈。
體悟
senior 不替對方做決定而是攤開選項:「A、B、C,就我掌握的情境我選 B,因為 X」——面試官知道你不知道的約束
junior 工具導向(該用 styled-components),senior 先講決策因素(顧效能就得看 bundle size)。別練 Uber,練你每天在做的有大量資料與表單的企業軟體。

技巧
非功能需求幾乎都可以量化(航程幾公里、油耗幾公升);講不出數字通常代表你把它當形容詞在講(「要很快」)
功能需求產出畫面與資料結構,非功能需求產出架構;混著談兩邊都講不深。
技巧
狀態的來源只有兩種:外部資料進來(loading / error / data)或使用者動作進來;用這兩個標籤掃畫面不會漏
不可再簡測試擋掉最常見錯誤:把可以算出來的東西存成狀態(篩選後的商品陣列)。面試裡可以主動宣告某狀態超出範圍,但要說出口。
觀念
狀態被抬高不是因為「很多元件想用」,而是它成了某個副作用(API 請求)的輸入——找到副作用發生的位置,高度就定了
as low as possible, as high as necessary。抬高的代價是整個子樹重算。
觀念
拆實體的判準不是欄位多不多,是變動頻率、生命週期、計算來源和主體一不一樣——價格單獨改、評分是聚合、到貨時間依賴地址
資源分得越乾淨,一個畫面要組的資源就越多——under-fetching 是 REST 的必然結果不是失誤,也是 BFF 與 GraphQL 的動機。
技巧
信封估算每一步都是「總量 × 一個佔比」,每個佔比都來自你先前問出來的問題——所以提問要先做
月 21.1 億 → 週 → 週二至四 → 週四 → 尖峰小時 2100 萬造訪 × 6.8 頁 = 1.36 億頁面瀏覽。行動佔七成:JS 要輕,圖片可以更小。
觀念
UI 靜動光譜是分岔點:靜態那端靠複製資產(CDN),動態那端靠移動運算(SSR、edge);電商卡中間所以兩套都得做
Core Web Vitals 是 SLI(量出多少),加一條目標線(LCP p75 ≤ 2.5s)才是目標。自己筆電量的數字過於樂觀,要靠 RUM。
體悟
推理姿勢:先算物理下限(光速單程 9ms),再看實際值(來回 140–160ms)差多少,差距就是可最佳化的空間
來回次數 × 地理距離是你付不起的成本,縮短距離是唯一能同時砍掉每一次來回的手段。TLS 1.3 一次來回,HTTP/3 合併 TCP 與 TLS 交握。
體悟
SSR、edge function、read replica 是同一招用三次:把東西搬近使用者;每次搬完問「還剩哪一段最長的路沒解」
搬完資產剩渲染,搬完渲染剩取資料,搬完資料才收斂。唯讀副本選的是可用性,換來最終一致性。hydration 空窗直接反映在 INP。
觀念
Gateway 解橫切關注點(每個服務都要做的事只做一次),BFF 解形狀不匹配(後端按領域切、畫面按視圖切)
判斷需要哪一個看痛點是「重複實作」還是「前端要打很多支再拼」。畫面差異不大時一個 BFF 加參數比兩個划算。BFF 由前端擁有是康威定律的伏筆。
觀念
溝通線隨人數平方成長(14 人 91 條)→ 拆團隊 → 康威定律要求同時拆系統 → 微前端;倒過來:系統邊界對不上團隊邊界,痛在每次發版
微前端代價:重複相依讓總下載量變大、跨應用路由與狀態變複雜——所以要補 design system(統一使用者看到的)與 monorepo(統一工程師碰到的)。
技巧
對著架構圖逐個元件問「這個只有一份嗎?」——只有一份的就是可用性的天花板(負載平衡器、主資料庫、DNS)
active-passive 不是免費的:待命台閒置也要付費,切換空窗就是停機時間;待命節點要定期演練否則設定早就過期。
體悟
好的非功能決策互相加成而不是交換:SSR 同時買到首屏速度、可索引、排名;語意 HTML 同時買到無障礙與 SEO
面試中把「順帶解決了什麼」講出來。分析工具丟給 web worker,主執行緒才不會被自己加的工具拖慢 INP。

觀念
Vue 2 用 defineProperty 在初始化時改寫每個屬性(事後新增偵測不到);Vue 3 用 Proxy 攔整個物件,動態屬性也攔得到
@vue/reactivity 是獨立 npm 套件,不裝 Vue 也能單獨用。這支影片重建的就是它內部真正的資料結構。
體悟
let total = price * quantity 存的是結果不是關係,乘法在賦值那一瞬間就用完了——所以要把「算 total 的程式碼」包成函式
函式是 JavaScript 裡唯一能把「還沒發生的計算」當成資料傳來傳去的東西。
觀念
「自動更新」藏兩個獨立能力:把該重跑的程式碼存下來(儲存端)、值改變當下自動去跑(觸發端);先確定存什麼才有東西可觸發
所以 track / trigger 都手動呼叫不是忘了,是自動化被刻意排在後面。真實 Vue 是在執行 effect 過程中讀到 price 才順手登記。
觀念
dep 用 Set 因為重複登記是常態(模板三處讀 price,同一個 effect 被 track 三次);判重用 ===,只有同一個函式參考才算
用陣列存改一次就重繪三次,effect 寫回自己讀過的值還可能無窮迴圈。demo 跑得動是因為 effect 是閉包,抓的是變數本身不是值。
觀念
depsMap 的 key 是屬性「名稱」不是值:值會變,依賴要在變前後指向同一位置;用 Map 因 key 可任意型別且不撞 prototype
屬性剛好叫 constructor 或 toString 時普通物件會出事。effect 也從裸變數改成 product.price——讀「某物件的某 key」才有東西可當 key。
技巧
「get → 沒有就建 → set 回去」的 lazy init 在每一層重複;trigger 要 if (dep),「沒人在等」是正常狀態不是錯誤
depsMap.set(key, (dep = new Set())) 一行做三件事:建 Set、讓 dep 指向它、存進 map——賦值本身是運算式會回傳值。
觀念
WeakMap 的 weak 才是重點:對 key 只持弱引用,物件沒人引用就連整張 depsMap 一起回收;用普通 Map 就是教科書級記憶體洩漏
targetMap 是全域永遠活著的變數,普通 Map 會永久扣住每個曾響應式的物件,元件卸載一千次就洩漏一千份。
觀念
target 這個名字來自 Proxy 攔截函式的第一個參數——被代理的原始物件;等自動追蹤上場,track 拿到的 target 就是它
觀念
自動化只需換掉呼叫時機(讀時 track、寫時 trigger = Proxy)加一個 activeEffect 記錄「此刻正在跑哪個 effect」
真實版本還要處理巢狀 effect、重跑前清掉舊依賴、觸發丟進排程佇列去重。

體悟
技能的價值來自稀缺;AI 讓能力人人可得時,貶值的不是你,是你原本靠來領先的那項「差距」
作者把「怕失去優勢」這種通常不會公開講的動機攤開,變化不是漸進而是已完成(Yesterday honestly)。
觀念
工具革命的模式:工具演進 → 難事變常態 → 舊差異化失效;焦慮不是被淘汰,是從領先變落後
「如果你選擇不進化」才可怕——重點在「選擇」二字。兩個現象(別人用新工具更快、差異化工作被 normalize)是同一件事的兩面。
體悟
把「手藝」和「目的」拆開:剪膠卷是手藝、拍電影是目的;手藝會被工具取代,目的不會,而且工具革命讓目的更容易達成
五十年前拍片要團隊、幾萬美元、幾週,現在一支 iPhone。喜歡剪膠卷沒有錯,但得接受它不再是原本那份工作。
體悟
如果你當年愛上了 tab 補全,你愛的就不是「每個字都自己打」;真正可攜的是工作習慣,不是特定技能
努力、持續學習、產出看得見的成果——不綁在舊工具上,所以新時代一樣管用。hold back the ocean 典出 Canute 命潮水退去:把「進化」重新定義成「不抵抗」。

觀念
orchestrator 是工頭不是工人:不寫程式,只「開工位、派任務、看進度、收成果」;Orca 本身不帶模型
它把你電腦上已裝好的各種 agent 接進同一個介面。後面每個功能都可歸到「工頭的工作」。
觀念
新 worktree 是新資料夾,node_modules 不會自動存在——所以要 setup script;Orca 等 setup 跑完才啟動 agent
agent 選單:Claude、Claude Agent Teams、Codex、OpenCode、Pi、Gemini、Antigravity、Kiro、Cline、Cursor…——agent-agnostic。
觀念
grab page element 複製的是渲染後的 DOM 片段,不是原始碼位置;agent 得自己在專案裡找到產生它的元件
DOM 和原始碼不一定一一對應(框架會加 class、hash)。提示列還能按 S 截圖給 agent 看。
體悟
agent 刻意不擴大範圍:grep 到兩處同樣 pattern,但判斷「使用者只要求他選的那張卡」只改一處——所以第二頁要再抓一次
Orca 在 agent 開始做事後依任務內容自動幫 worktree / 分支取有意義的名字,資料夾名不變。
觀念
AI 生成的 commit message 從 diff 反推技術本質(修 flex 版面文字溢出),而不是照抄 prompt
PR 標題直接拿分支名轉成,內文 No description provided——個人專案 OK,團隊協作是缺口。
技巧
平行編排的前提是先把工作切成互不重疊的小任務(Improve 掃出編號計畫檔);不碰同一批檔案,PR 才能各自合併
TypeScript 錯誤、SEO metadata、lint 清理——小、獨立、不會碰同一批檔案。會改到同一個檔案的任務,收成時 merge 會打架。
體悟
平行跑時額度/費用是每個 agent 各自的限制,orchestrator 幫不上忙;額度用完的直接砍,不讓它擋住其他人
Antigravity Starter Quota 做到一半用完;做到一半的改動仍在 worktree 裡,關鍵任務可換 agent 接手同一個 worktree。
技巧
在 diff 上加註解送回 agent:比自己改省力、比重打 prompt 精準,因為註解自帶檔案與行號——工頭不寫 code 只批改
Orca 把註解組成 prompt 塞回該 worktree 的 agent 對話,agent 再改、你再看 diff,人機閉環。
觀念
三種編排共用同一套基礎設施,差別只在任務怎麼分配:平行分工(N×N)、比稿(N×1 挑一個)、handoff(1 條鏈要順序不要隔離)
比稿把 Orca 從生產工具變評測工具;sub agents 是 handoff 的變體,拆解與分派由 agent 決定。後兩種影片沒示範。
體悟
ADE 的第一使用者是 agent:四個賣點都在解「同時管好幾個 agent」——互踩檔案、看不到瀏覽器、人不在、任務太大
IDE 的使用者是人,工具幫人寫程式;ADE 幫人「管理正在寫程式的 agent」。
觀念
Orca 對每個 agent 的「整合」本質上就是一條啟動命令,而且預設都帶跳過人工確認的旗標
claude --dangerously-skip-permissions、copilot --yolo、aider --yes-always。所以新 agent 很容易加進清單;agent 在 Orca 裡常無人看管地跑。
觀念
git worktree add 讓新目錄的 .git 只是指向原 repo 的檔案:共用歷史、commit 互相可見,工作目錄各自獨立
這是「多個 agent 同時跑不會互踩檔案」的技術基礎。Create worktree 可貼 issue 編號或 PR/MR 網址,Orca 據此命名 branch——worktree 對應一個工作項目。
技巧
前後端放不同 worktree 並行的前提是介面(API 路徑、資料格式)先講好,否則各自做完 merge 時對不上
feature 彼此依賴就不能這樣切。Orca 監看每個 terminal 分頁的程序,認出已註冊的 agent 命令就掛上 session 條目。
觀念
agent 間傳訊不是特殊協定:把另一個 agent 產生的文字當成新的使用者輸入塞進對話回合——所以任何 CLI agent 都能參與
skill 教它在訊息尾加「continue your implementation afterward」,避免被打斷的 agent 忘記回去做原本的事。
體悟
agent 為了 demo 好看會編造貌似真實的資料(home.arpa、10.20.x);審閱時要分清「它查到的」和「它編的」
作者誤判「它加了我真實的 Proxmox 節點」,其實是 RFC 8375 保留網域與教科書式私有位址。agent prompt 型 quick command 每次用都多一個 session,用完記得關。
觀念
annotate 把 selector、bounds、styles、DOM path 全打包;scoped class 讓 agent 能 grep 到對應檔案
消除「用文字向 agent 描述我在說頁面上哪個東西」的溝通成本。送出時其實是新開一個 agent:沒有前面脈絡、但不打斷正在做事的。
技巧
新增依賴後要重啟 dev server:Vite 啟動時就決定預先打包哪些依賴,執行中新裝的套件模組解析會對不上
「大部分時候重啟就好」不是玄學。程式邏輯錯重啟沒用,那時才叫 agent 修。手機端最實用的是回應 agent 的權限確認。
技巧
先 publish 到遠端再刪 worktree 才安全;沒 push 就刪,branch 一併刪除要靠 reflog 找回
建了 MR 之後還要有人在 GitLab 上接受它 main 才會有 commit——影片剪掉了這步。19 個新檔、package-lock +1845 行是「五分鐘」的實際規模。
觀念
orca terminal wait 是輪詢式等待,協調 agent 本身持續耗 token;Yolo 不是攔截確認,是換一組啟動旗標
Pi 沒有旗標因為它本來就不問——這是選 Pi 的原因。多個 agent 各自持有一份 context,prompt cache 閒置失效要重送整份。sub agent 用低 thinking mode。
技巧
防 orchestration 誤啟不想用的 agent:治標是 prompt 加 guardrail,治本是在設定裡停用讓它根本看不到
反過來也可以刻意混用:前端給 Claude、簡單 API 給 Pi + MiniMax。

觀念
同步處理的三個問題(延遲、脆弱、尖峰)都來自「接收」和「處理」綁在同一個同步呼叫裡
queue 分別用非同步、重新派送、緩衝來解——三個性質對三個痛點。
觀念
consumer 是 pull & process:主動拉才能依自己容量取件,這是 back pressure 的基礎
decoupling 還有時間解耦:兩端不必同時在線。餐廳 ticket rail:服務生放單就走,廚師準備好再取。
觀念
ack 解決遺失但引入重複:SQS / RabbitMQ 是「競爭 + 鎖定」,Kafka 是「分割 + 獨占」
「處理完、ack 前掛掉」無法消除——所以下一步是投遞保證。
技巧
面試標準答案:at-least-once + 冪等 consumer;「+1」改寫成「設成 54」或用訊息 ID 去重;別承諾 exactly-once
只能在「可能重複」和「可能遺失」之間選一個。重複的責任歸 consumer,因為只有它知道業務操作能不能重做。
技巧
該不該用 queue 只問「使用者現在就需要這個結果嗎」;非功能需求寫了 500ms 內回應就別塞 queue
初中階常犯:看到 queue 很好就到處用。另一個反例:需要嚴格全域順序的工作流,partition 後只能保證 partition 內順序。
觀念
consumer 不能多於 partition;partition key 在順序與均勻之間取捨,跟 shard key 同構
存 100 再提 50 落到不同 partition 提款可能先跑,用 account ID 當 key;用城市當 key 紐約爆滿。獨占 partition 既避免重複消費也是順序來源。
第 8 段 →
Partition、consumer group、partition key
·
Partition Consumer group Partition key Hot partition
體悟
queue 是 buffer 不創造容量:producer 長期快過 consumer 就會爆;back pressure 讓失敗發生在最便宜的地方(入口拒絕)
三層對策:scaling 增加容量、back pressure 減少輸入、alerting 知道何時該做前兩者。最低限度對 queue depth 設告警。
技巧
主動提「max retry + DLQ」顯示資深度;暫時性失敗的重試要加指數退避,DLQ 本身也要監控
poison message 沒護欄會無限重試、卡住後面所有訊息。DLQ 是隔離思想的再應用。
觀念
Kafka 是有保留期的 log 不是消費即刪:consumer 只移動讀取位置,所以多個 group 可獨立讀同一份、可 replay 修 bug
consumer 有 bug 處理錯了,換新版告訴它「從一小時前重來」。複製到幾個 broker 才算寫入成功(acks)影響延遲與耐久取捨。
技巧
選型:要重播或多方獨立消費 → Kafka;AWS 上簡單可靠的工作佇列 → SQS;要依內容路由到不同 consumer → RabbitMQ
沒有 go-to 就選 Kafka;但它運維成本高,面試裡要說得出你需要它的哪個能力。SQS standard 盡力排序、FIFO 嚴格排序但吞吐低。

觀念
六個其實是一比五:差在 callback 回傳什麼——map 回傳普通值,其他五個回傳新 Observable,才有「誰等誰、誰砍誰」
主線變成「Observable 裡裝著 Observable」,必須有人決定怎麼攤平;map 沒有這個決策點所以沒得比。pipe 那行只是描述,subscribe 才執行。
技巧
對照實驗法:固定所有變因只留 operator 一個變數;delay 掛在內層是刻意製造「下一個值到時前一個還在跑」的衝突
沒有 delay,五個工作瞬間結束彼此不重疊,四個 operator 輸出一模一樣。差別只存在於重疊的那一刻。
觀念
mergeMap 不保證輸出順序:哪個內層先吐值就先送誰;第二參數 concurrent 限制同時數量,設 1 就等於 concatMap
示範裡五個 delay 都 500ms 才剛好看起來是 0 到 4;五個 HTTP 同時發,回來順序由伺服器決定。flatMap 只是別名。
觀念
concatMap 的前提是內層會完成(換成 interval 就永遠卡住);佇列沒有上限,來源長期快過處理就記憶體漲
適合「每一筆都不能丟、順序不能亂」:離線累積的操作依序送出、照順序寫日誌;不適合綁在使用者連續輸入上。
觀念
switchMap 被取消的內層不會發 complete,清理要用 finalize;取消會往下傳讓瀏覽器真的中止 HTTP——唯一真省流量的策略
搜尋框即時建議的經典解:一次解決浪費與「舊結果晚回來蓋掉新的」兩個問題。
技巧
四句記法:都不管別人 mergeMap、把別人排後面 concatMap、砍舊留新 switchMap、擋新留舊 exhaustMap
exhaustMap 是靜悄悄丟掉不排隊不報錯:送出鈕連點只送一次、token 續期只續一次。
體悟
判準在外層不在內層:來源一次性吐值時四個怎麼選都對;來源是點擊、輸入框、路由參數、輪詢才分勝負
getUser 只吐一個 user 就完成,只有一個內層被建立,四個策略都無事可做——所以 concatMap 與 switchMap 看起來一樣。選錯是「使用者手快才重現」的 bug。
觀念
agent 答錯時的語氣跟答對一模一樣(calibration 問題);所有解法本質都在替它補上自己給不出的「信心來源」
能跑起來、能驗證、有硬規則擋著。會說「我不確定」的模型輸出可以分流,永遠篤定的逼你每次全部檢查。
觀念
verification 把錯誤訊號的來源從人換成環境:迴圈變成改 → 執行 → 觀察 → 再改,環境不會累、能同時服務二十個 agent
它不保證「好」程式,只保證「正確」的程式——把品質拆成兩個可分別處理的問題。四個例子涵蓋正確性、CPU、記憶體、實際介面。
體悟
沒有 verification skill 時你自己就是 verifier,也就是瓶頸;agent 數量上限 = 人的注意力 ÷ 每次往返成本
好的 verification skill 大半內容不是「怎麼操作」,而是「多個 agent 同時跑時怎麼不互相干擾」(worktree 各自 port 與 user-data-dir)。
技巧
feature map 只寫「怎麼使用功能」不寫「怎麼實作」,因為程式碼變得比文件快——把最容易過期的部分排除在外
驗收標準:一張截圖加三個問號的回報,agent 也要能對應到功能。密度高到人手寫跟不上,要 create / maintain skill 自動產與更新。
技巧
判斷 agent 幻覺看過程不看結果:tool call 顯示它根本沒讀過相關程式碼——過程指標能在後果造成前發現
每觀察到一種失敗模式就寫成一個 skill;面對「能力強但零脈絡、五秒前才報到的新人」,教法就是寫下來。
觀念
eval 是 skill 的單元測試:subagent 的目錄要命名得看不出在被評測(評測意識);要跑一批才有分佈可看
單次結果分不出「skill 改好了」和「這次運氣好」。
技巧
迭代迴圈:讀 tool call 找失敗模式 → 寫 skill → eval 量分 → 換一個模型當 judge 爬山;分數只反映 rubric 寫了什麼
人只出現在第一步和最後一步。同一模型既寫又評,偏好會同時出現在兩邊。品味最終體現在 rubric 上。
體悟
大公司的護欄本來就是為能力最弱的工程師設計的,剛好也擋住 agent;真正危險的是沒有護欄的綠地專案
「AI slop 之前就有 human slop」:把 agent 放進「能力不均的貢獻者」這個位置。vibe code 的原型會長成 organic architecture——被捷徑堆出來的。
觀念
禁註解的理由:agent 分不清「這次的指正」和「永遠的規則」,會把針對一個 PR 的一句話寫成程式碼裡的永久全域規則
原則:agent 做不好的事就全部禁掉(useEffect 直接禁,CI 失敗)。
體悟
「最短路徑就是最好的路徑」:agent 愛抄捷徑,就先觀察它抄哪條,再把那條改成正解;分層:架構 > CI/lint > rules > skill
前兩層會讓 CI 變紅是硬約束;rules、skill、style guide 是軟的,agent 會忘,只能疊加不能當唯一防線。敢不看程式碼是因為信的是第一二層。
技巧
每次你必須在 PR 上留言糾正,就是壞味道:問怎麼變成 lint 規則、CI failure,或從架構讓問題根本不可能發生
靠人 review 維持的不變量,成本正比於 PR 數量,往曲線右邊走時率先崩潰。編譯器擋掉的那類錯誤人就不必檢查,但能編過 ≠ 邏輯正確。
體悟
嚴格約束不是成本項而是擴張項:唯一那條路設計成最短,不熟的人反而更容易走對——PM 與設計師也能送出可蓋章的 PR
信任的對象從來不是模型本身,而是那個讓錯誤難以發生的環境。介面決定誰進得來,架構決定他們送的東西能不能合。

觀念
掉線卻不知道:對方沒送 FIN / RST(切網路、闔筆電、NAT 清表)時本端 TCP 一直「已連線」,要送資料重試逾時才報錯
應用層被動等訊息就永遠不會知道。這裡的 ping/pong 是應用層自訂的一問一答,不是 WebSocket 協定內建的控制訊框。
技巧
ping 用 binary 訊框送,client 不用解析內容就能分辨;ws.send(1) 會變字元 '1',要 Buffer.from([1])
{ binary: true } 是 ws 套件 send() 的選項。影片裡 client 只檢查是不是 binary 不比對值,所以還是能動。
觀念
擴充第三方套件型別用 module augmentation(先 import 再 declare module);擴充瀏覽器內建用 extends + as
沒先 import,TypeScript 會把 declare module 當成全新模組,型別整個被蓋掉。狀態掛在 socket 上:terminate 從 clients 移除時狀態跟著消失,不用另外清。
技巧
server 端「先設 isAlive=false 再 ping,下一輪還是 false 就 terminate」;判死要一整個 interval,最多延遲兩個
這一輪把旗子放下,下一輪檢查有沒有被 pong 舉回來。
觀念
heartbeat 遍歷時不篩 readyState(目標正是 OPEN 但已死的);用 terminate 不用 close(死連線等不到關閉握手)
技巧
client 用可重設的 setTimeout 當看門狗:收到 ping 就 clear 再 set,timeout 比 server 間隔多一段緩衝
server 主動方用 setInterval 固定節奏;client 被動方只要「倒數歸零重來」。寫成 1000 * (5 + 1) 把緩衝寫清楚。
觀念
不清舊 timeout 不是優化而是正確性:第一個 timeout 沒取消,之後 ping 都正常也會每 6 秒 close 一次
瀏覽器 setTimeout 其實回傳 number,編輯器顯示 NodeJS.Timeout 是 @types/node 蓋過 DOM;可攜寫法是 ReturnType<typeof setTimeout>。
觀念
瀏覽器 send() 傳數字會轉字串走 text 訊框;要用 Uint8Array(ArrayBufferView)才自動走 binary
server 的 isBinary 才會是 true,data[0] === 1 才成立;否則 pong 被當一般訊息廣播出去。
技巧
用 Object.prototype.toString.call 比對 '[object Blob]' 判斷 binary:不受覆寫影響、跨 realm 可用
binaryType 設成 'arraybuffer' 就改比對 '[object ArrayBuffer]'。
技巧
'open' 時也呼叫一次 heartbeat(),否則第一個 ping 之前 client 沒有倒數在跑;'close' 時 clearTimeout
影片沒處理這個邊界:server 在第一個 interval 內就死,client 永遠不會逾時。沒清 timeout 的 close 會錯誤觸發重連邏輯。
技巧
interval 不能小於最差 RTT(否則活的被誤判死);正式環境 10–30 秒;兩邊常數沒共用來源,改一邊要記得改另一邊
實測「pong 數 = 活連線數」同時證明三件事。影片只驗了正常關閉;真正的死連線要 DevTools 切 offline 等兩個 interval。下一步:exponential backoff 重連。

觀念
resolve / reject 是 constructor 造出來傳進 executor 的,不是 executor 提供的
Promise Capability Record 把一顆 promise 與它專屬的兩個函式綁成一組。方向搞反會誤以為能在別處拿到某顆 promise 的 resolve。
觀念
狀態只能單向轉一次:之後再呼叫 resolve / reject 完全沒效果、不報錯也不改值;executor 是同步跑的
new Promise 還沒回傳,executor 裡的程式碼就已經執行完了。
觀念
then 只負責存(建 reaction record),觸發由 resolve 負責,執行時機由 event loop 決定
fulfill reactions 是列表不是單格,同一顆 promise 可串多個 then。record 裡還記著「跑完要 resolve 哪顆下游 promise」,這是鏈式的伏筆。
觀念
[[PromiseIsHandled]] 串上 then 才變 true;沒人接手的 rejected promise 靠它被判成 unhandled
體悟
executor 裡沒有非同步工作的 promise 只是繞了一圈的同步值,除了延後一輪 microtask 沒有任何好處
Promise 不會讓程式多執行緒、不會讓同步重運算變快;它只是把「一件正在等的工作何時完成」包成可掛 handler 的物件。new Promise 幾乎總是出現在 promisify 舊 callback API 的場合。
觀念
setTimeout + then 要等兩次 call stack 空:script 跑完 callback 才進,callback 跑完 handler 才進
少算一次就把輸出順序算錯。非阻塞分兩層:等待是環境在等不佔 JS 執行緒;結果處理排進 microtask 不插隊。
觀念
promise 完全不知道有 timer 存在,是 callback 主動去 resolve 它;計時器被取消,那顆 promise 就永遠 pending
觀念
鏈上每個 then 各一顆 promise、各花一輪 microtask;回傳 promise 會被吸收;忘 return 下游拿 undefined
錯誤沿鏈往下找第一個 catch,因為 reject reactions 用同一套 record 機制——所以 catch 放鏈尾能接住整條鏈。鏈越長結果出現越晚。
技巧
同一段 script 的同步 console.log 一定先印完 then 才跑,跟 resolve 多早無關;已 resolve 的也延後一輪
1、3、2 那題:then 在已 resolve 的 promise 上跳過存列表、直接排一份 job,但仍至少延後一輪 microtask。排程不等於執行。

觀念
execution context 本身不存變數、只持有指標;真正存「名字 → 值」的是 environment record
畫面上每一個叫「某某 environment」的欄位,本質都只是指向某個 environment record 的一條線。
觀念
creation phase 只處理當前這一層的宣告;函式體裡的宣告要等它被呼叫、建立自己的 context 時才處理
之後所有「為什麼可以在宣告前呼叫函式」「為什麼 const 提前存取報錯」都只是在問:這件事發生在哪個階段。
觀念
兩個 realm 各有一套 intrinsics:iframe 的陣列 instanceof Array 為 false,要用 Array.isArray
名字掛在 global object 上,實體住在 intrinsics 裡(規格記作 %Array%);把 Array 重新賦值只改 global object 屬性,引擎內部仍走 intrinsics。
觀念
var 與函式宣告在全域會掛上 global object,const / let / class 不會;ES module 的頂層宣告則一律不掛
spec 屬性是每個 JS 環境都要有的,host 屬性是宿主自己加的——document 在 Node 不存在不是缺陷。
觀念
一個環境兩個抽屜:先問 declarative 再問 object record——所以 const x 之後 globalThis.x 是 undefined
outer env 在全域是 null,這是遞迴查找的終止條件:走到 null 還沒找到就 ReferenceError。
觀念
lexical 與 variable environment 在函式裡可指向不同 record:每進區塊 lexical 換新、variable 留在函式層
這正是 if 區塊裡的 var 會洩漏到區塊外、let 不會的原因;全域兩者重合只是因為外面沒有更大的區塊。
觀念
uninitialized 是引擎內部的第三種狀態:格子存在但貼著封條,讀到丟錯誤而不是回傳 undefined
function object 的 environment 屬性在建立那一刻就固定指向宣告處,之後傳到哪、被誰呼叫都不變——語彙作用域的具體實作。
體悟
參數在 creation phase 就初始化(值來自呼叫端),函式內 const 仍 uninitialized;outer env 抄的是宣告處不是呼叫處
如果 outer env 抄呼叫者的環境,JavaScript 就變成動態作用域,scope chain 與 closure 都不成立。
第 9 段 →
Execution phase 與函式呼叫建立新 EC
·
function execution context function environment record scope chain
觀念
hoisting 三種待遇只差 creation phase 結束時拿到什麼:封條、undefined、完整 function object
TDZ 起點是所在區塊的開頭不是檔案開頭。let 重複宣告是 SyntaxError(解析階段),跟 hoisting 無關。var 的 undefined 危險在讓錯誤靜默。
觀念
closure 沒有複製任何值,只是讓一個 environment record 的存活期超過建立它的那個 execution context
同一次呼叫 outer 產生的多個內層函式共用同一份 record;每次重新呼叫 outer 都是新的一份。查找是沿 outer env 走,不是往下翻 call stack。
觀念
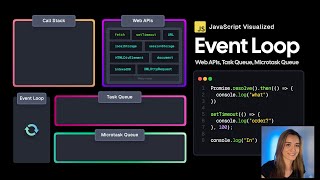
engine ≠ runtime:call stack 與 heap 在 engine;web APIs、兩個 queue、event loop 是宿主提供的
所以 setTimeout、fetch 在 ECMAScript 規格裡找不到;同一份 JS 換到 Node.js,engine 一樣但周邊零件換了一套。
觀念
兩種長任務要分清:重運算是真的在 call stack 上算(只能 Web Worker);網路請求、計時器是在等別人,等待不需要占堆疊
凍結的是整個分頁:算繪、捲動、點擊都跟你的 JS 共用主執行緒。web API 那套只解「在等別人」的那種。
觀念
瀏覽器本身是多執行緒的,web API 只是界線上的門把;「是 web API」不等於「是非同步的」(localStorage 就是同步)
你在 call stack 上轉一下門把(登記工作),實際的活由門後的瀏覽器做,堆疊立刻恢復空閒。
體悟
callback 不能直接插回堆疊是因為 run-to-completion 保證——這是整個語言不需要鎖的前提
讓 callback 想回來就回來,你讀完 obj.a 正要讀 obj.b 之間值就可能被改。登記的 callback 不保證會回來(使用者一直不理授權視窗)。
觀念
event loop 不執行程式碼、不排程、不決定優先順序,只有一條規則:call stack 空了就從佇列搬一個上去
「空了」指整支同步程式碼跑完,不是某個函式回傳。佇列 FIFO,但兩個 fetch 誰先回來由瀏覽器背景決定,不等於呼叫順序。
觀念
setTimeout 的延遲是到「進入 task queue」為止,不是到執行;setTimeout 0 仍走完整回程路,巢狀超過 5 層夾到 4ms
背景分頁降頻到一秒一次;重運算長任務會讓所有計時器一起遲到——所以它不能拿來精準計時。同步 console.log 永遠贏過任何 setTimeout。
觀念
.then 是同步執行的(把 handler 登記進 reactions 清單),handler 才是非同步的;落定才排進 microtask queue
microtask queue 收:then/catch/finally、await 之後、queueMicrotask、MutationObserver。setTimeout 0 vs Promise.resolve().then 永遠 promise 先。
觀念
microtask 優先權的代價:規則是「清空」不是「取一個」,會自我複製的 microtask 讓 task queue 餓死、畫面永遠不更新
優先權的設計目的是讓同一件事的後續處理不被點擊或計時器插隊,promise 鏈看起來連續發生。
技巧
推順序三步:同步碼跑完 → 清空 microtask(含中途新增的)→ 拿一個 task → 再 checkpoint;51342 的 4 在 2 前面就是這條
setTimeout 寫 10ms 或 0ms 都排最後,跟延遲長短無關。promisify 只是可讀性:resolve 進 task queue,落定後 handler 才進 microtask,多繞一層。
技巧
四問除錯「為什麼這行比那行晚印」:同步還是非同步?誰完成的?進哪個佇列?call stack 空了沒、microtask 清空了沒?
練習順序:同步 vs setTimeout 0 → 加 Promise.then → 巢狀 queueMicrotask → 遞迴 queueMicrotask 親眼看卡死。Node.js 多了 process.nextTick 與多個 phase,先固定瀏覽器。

體悟
垃圾回收的判準不是「執行完了就死」而是「沒人參考才死」;closure 就是「該被回收的東西沒被回收」的狀態
outer 執行完 context 與 record 被回收,但 outer function object 留著——因為全域 record 裡有綁定指著它。整支影片就是在製造第二個參考者。
觀念
[[Environment]] 記的是「被定義的地方」不是「被呼叫的地方」——這就是語彙作用域的實作依據
你讀程式碼看到的巢狀結構,就是引擎最後串出來的那條鏈。宣告函式就有這條線,免費的。
觀念
inner 與 record 互相參考的環救不了對方:現代引擎用可達性(從根走得到才留),不是參考計數
問題從來不是「有沒有人指著它」,而是「從外面走不走得到它」。早期 IE 的 DOM 循環參考就是參考計數漏的。
觀念
closure 保留的是整份 environment record,不是 count 的複本:同層其他變數也一起留下、看到的是當下值不是快照
execution context 死了,environment record 活著。return inner 不是 inner()——一字之差決定外面接到函式還是數字。
觀念
呼叫時新 record 的 [[OuterEnv]] 抄自 function object 的 [[Environment]]——定義時寫死的線,呼叫時才兌現
鏈是單向的:inner 找得到 outer 的、outer 找不到 inner 的;盡頭是 global record([[OuterEnv]] 為 null),再找不到就 ReferenceError。
技巧
指認 closure 的兩個條件:有巢狀函式、內層函式的參考留在外層之外(return、塞進陣列、註冊監聽器、setTimeout 都算)
closure 不是呼叫時才建立:function object 一建立關係就定了,只是要等外層結束、參考仍在,才用這個名字稱呼它。
觀念
被保留的 record 是每次呼叫外層函式時才產生的:呼叫幾次就幾個 closure;同一次呼叫回傳的兩個函式共用同一份
createCounter 測驗答案 1、1、2:答 1、2、3 是把 count 當函式共用狀態,答 1、1、1 是以為每次呼叫都重跑外層。每次呼叫 counter1() 的 increment record 用完就丟,累積的只有外層那份。
技巧
memoize 的 cache 必須住在外層 record(內層每次呼叫都是新的);只對純函式安全;物件鍵轉字串,10 與 "10" 會撞格
cache 被 closure 釘住永遠不會自己縮小,用 Map 要自己管容量。
技巧
函式再小也扣住整份作用域:要縮小成本就縮小那一層放的東西,把大資料放在沒有任何回傳函式參考得到的作用域
事件監聽器、setInterval 回呼沒解除註冊,是前端記憶體洩漏最典型的來源——同一個機制。
技巧
驗證不要猜:DevTools Memory 拍 heap snapshot,看大物件的 Retainers 路徑有沒有 context / closure 節點

觀念
WebSocket 難擴展的根因:狀態綁在某一台伺服器的記憶體(socket buffer、這 client 是誰、訂閱了什麼),HTTP 做完就丟
所以後面任何把負載搬到別台的做法都得先處理這些狀態要放哪——這是整個題目的主軸。
觀念
「百萬連線」benchmark 量的是空連線的上限;heartbeat、buffer、backpressure 等九項「電池」每項都在每條連線上加成本
Batteries not included:Heartbeat、Buffer undelivered、Message routing、Broadcast、Backpressure、Reconnection、Acks、Encryption、Multiplexing。
觀念
long polling fallback 的擴展方式跟 WebSocket 完全不同:它是散在多台機器上的多個短命請求,要用 HTTP 那套
技巧
「一台能撐多少」只能用自己的實作、真實訊息流量壓測;瓶頸通常是記憶體與 OS 限制(file descriptor 上限),不是 CPU
空連線一台 16 GB 可到數十萬,加上九項電池與真實訊息流可能掉一個數量級。別人的數字沒有參考價值。
體悟
單點故障把「貴」「撞上限」這些能用錢解決的問題,升級成用錢也解不了的結構問題;單台做不到無中斷部署
按峰值配置的浪費在垂直擴展下無解——單台不能半夜縮小白天變大。memory leak 或雲端 AZ 離線都會整個下線。
觀念
load balancer 只在 handshake 那一刻分配,之後長連線固定在那台;round robin 分的是新連線不是訊息
某個使用者這輩子的所有訊息都只經過他被分到的那一台。舊連線不會走,round robin 對長連線不一定平均。
觀念
backplane 不是把連線集中,而是把「訊息與狀態的可見性」集中:socket 仍在各台,每台收到 pub/sub 後檢查自己手上有沒有目標
socket 搬不走,能搬走的是「誰在哪、訂閱什麼、有什麼要送」這層應用狀態。A → LB → Server 1 → Redis → Server 2 → B。
觀念
Redis pub/sub 是 fire-and-forget:訂閱者不在線就收不到,跟 buffering 衝突——要 Streams 或持久化 broker
觀念
水平擴展四個挑戰是一條因果鏈:狀態同步 → backplane 成新單點 → load shedding → thundering herd
presence 用帶 TTL 的 Redis 紀錄自動過期;Redis 用 Sentinel / Cluster;重連用 exponential backoff + jitter。autoscaling 縮機器直接砍就是人為的 thundering herd。
技巧
用「停機的代價」換「架構複雜度」;中間路線:先單台、但一開始就把狀態放 process 外,日後加第二台只需加 load balancer
停機代價低(內部工具、早期產品)先用單台加好的容錯;金融、交易、即時協作一開始就水平擴展。「連線數」不是好的容量單位,因為連線各不相同。

觀念
更累的機制:以前是 macro → 一串 micro(休息 + 心流)→ macro;現在 macro 連發,被拿掉的正是省力又有回饋的那層
macro 決定的影響更遠、更快,錯的 macro 會被 LLM 以同樣速度放大,所以他把力氣花在 spec 與 review。
體悟
judgement 和 operation 是兩種技能:「像回到 junior」不是能力退步,是「讓 agent 產出你要的東西」這項操作技能歸零
標準決定體感:「能動就好」幾分鐘達成所以輕鬆;「line for line」得像 junior 一樣反覆被拒絕。
體悟
system design 直覺過去是 micro 搏鬥的副產品;micro 被 LLM 拿走,副產品也跟著消失——下一代怎麼訓練沒有答案
價值集中在有判斷力的人身上,而判斷力的生產線壞了。學徒制被提出:讓新人在有判斷力的人旁邊做真實的事。
體悟
多 agent loop 對中位數開發者不實際的三個主張:token 成本、harness 每版飄移沒 baseline、缺 receipts
用「中位數」不用「平均」:平均被少數重度使用者拉高。token 變成需要治理的稀缺資源,Uber 四個月燒光全年預算後設硬上限。
技巧
選 harness:做得越少、改得越少越好——小 system prompt、少 tool、最少注入 context,才分得清是誰的功勞
要建立自己對模型的直覺需要穩定的實驗環境。Pi 極簡可客製,Herdr 是為多 agent 同時跑設計的 tmux。
技巧
review 移到 PR 之前(本地逐行看過、改過再推),每個 PR 300–800 行 stacked;agent 的速度用在迭代次數不是單次產量
300–800 行是「一個人能真正讀懂」的上限;agent 能一次吐三千行但刻意不讓它。Plannotator 的註解直接注入回 agent session。
觀念
spec 不是先寫好再實作,而是對話漸漸長成 spec、最後才固化成 markdown——它是「已經對齊過的理解」的快照
agent 提案、他標註、agent 修、再標註;用 /plannotator last 直接編輯 agent 的話,修正它的理解而不是寫文件。「終於相信有共同理解」是 senior 判斷,junior 可能太早相信。
技巧
開工先問 agent 你已經知道答案的問題(Hono 怎麼運作、codebase 既有抽象):既是驗證、又是 context 建材、還分區
知道答案才能判斷 agent 研究對不對;結論留在對話裡實作時不用重講;每個主題在自己分支研究,/tree 跳回根部只留審過的小結。
技巧
agent 擅長填空、不擅長設計空格:spec = 型別 + interface + call stack + 先寫的測試,約 650–1000 行
型別定形狀、call stack 定路徑(防它開你不想要的新路)、測試定驗收(防過型別檢查但行為不對)。spec 比實作長:思考成本刻意放在動手前。
觀念
「幫既有 function 寫測試全是垃圾」:那時 agent 在描述現況不是填空,會把 bug 當成規格;先定紮實測試再讓它實作效果好十倍
體悟
sub-agent 的問題不在能力,在誰做「摘要」這個決定——摘要就是決定什麼進主 context,這是最重要的 macro 決定
漂亮的摘要讓 senior 也不再自己想。sub-agent 真正解的是 context 容量問題;工作單位本來就小(300–800 行)容量問題就不存在。
技巧
把每次 review 反覆糾正的同一件事(不要 is Record、不要一路傳 unknown)寫進 skill 做第一輪 review;省五分鐘就算贏
自動化的是流程不是判斷:queue 裡每一步都是他手動走過幾百次的步驟;品味明確寫下;期望值很低。

觀念
WebSocket 不是 HTTP 的延伸,是獨立的 TCP 協定;跟 HTTP 唯一交集是 handshake 被伺服器讀成 upgrade request
HTTP/1.1 有 keep-alive 可重用連線,但仍是客戶端問、伺服器答;伺服器不能主動推才是 WebSocket 真正要解的。
觀念
Sec-WebSocket-Key 不是密碼也不加密:瀏覽器不讓 JS 設 Sec- 開頭的標頭,所以只有真正的 WebSocket API 送得出它
Connection: Upgrade 是 hop-by-hop 標頭告訴 proxy 要換協定,Upgrade: websocket 才指名換成什麼,少一個伺服器都該拒絕。Origin 可擋跨站連線。
觀念
Accept = base64(SHA-1(Key + 固定 GUID)),證明伺服器懂 WebSocket 規格,不是身分驗證——Key 明文、公式公開
GUID 是 RFC 6455 寫死的 258EAFA5-E014-47DA-95CA-C5AB0DC85B11;普通 HTTP 伺服器原樣回音也算不出。SHA-1 在此只是指紋不涉安全強度。
觀念
101 回應結尾空行之後,同一個 socket 的下一個位元組就依 WebSocket 格式解讀:連線沒換,只是上面跑的協定換了
wss 順序是 TCP 三向交握 → TLS 交握 → 才送 upgrade GET,所以 handshake 本身也加密。ws 預設 80、wss 預設 443。安全來自 TLS,身分靠 Origin / cookie / token。
觀念
payload length 7 位元:0–125 直接是長度、126 再接 16 位元、127 再接 64 位元——小訊息只花 2 位元組標頭
opcode:0x0 接續、0x1 文字(合法 UTF-8)、0x2 二進位、0x8 關閉、0x9 ping、0xA pong。客戶端→伺服器一律遮罩,伺服器送出不可遮罩。
體悟
masking 防的不是人而是 cache poisoning:key 由瀏覽器隨機產生、腳本無法指定,所以惡意腳本排不出像 HTTP 的線上位元組
惡意網頁可讓 payload 長成 GET /script.js HTTP/1.1,舊 proxy 誤快取後污染其他使用者。所以 key 每個 frame 都要重新隨機、且只有客戶端→伺服器要遮罩。
觀念
分片時第一片帶型別 opcode、後續每片都是 0x0 continuation;控制 frame(ping / pong / close)可以插在片段之間
所以大訊息傳到一半仍能回 pong 保活。兩則資料訊息的片段不可交錯。瀏覽器 API 不讓你控制分片,伺服器端函式庫才有選項。
技巧
只要伺服器單向推就用 SSE;大量請求/回應式 API 靠 HTTP/2 多工;WebSocket 的代價是每條連線都是伺服器上的長期狀態
擴展時要處理連線親和性與斷線重連。聊天與報價吃持續連線 + 小標頭;遊戲與協作畫布吃同一條 TCP 的有序傳輸。

體悟
卡住的原因不是懂太少,是看得見太多合理選項;會讓人癱瘓的都是「沒有絕對優劣、只有適用情境」的成對選項
問題要從「怎麼背下正確設計」改寫成「需求不完整時怎麼做出合理決定並解釋取捨」——後者才有可練習的動作。
體悟
兩個方案技術上難分高下時,決定勝負的是團隊會不會維護它;真正的限制全在技術之外
導入成本不只是寫程式的時間,是往後每次上線、除錯、招人、交接都要付的持有成本。
觀念
分頁的判準:資料會不會在瀏覽期間變動、使用者需不需要回到特定位置——動態牆用 offset 會重複看到同一則
搜尋結果是靜態快照,offset 的位移弱點幾乎不發生、跳任意頁正是使用者要的;feed 新貼文隨時插到最前面,cursor 指向資料本身所以免疫。
觀念
衝突的機率 × 衝突的代價決定你需要多複雜的衝突解決;「怎麼傳」和「衝突怎麼解」是可以分開決定的兩個維度
白板上兩人同時改同一個形狀是常態(要 CRDT / OT);看板上同時改同一欄位罕見,後寫覆蓋就夠。選了 WebSocket 不等於得整套上。
技巧
太早解題的症狀:三十秒內就開始講技術名詞。先分功能性與非功能性需求,後者才是架構的驅動力、也最常被題目省略
Clarify 問的三件事(使用者體驗、規模/一致性/交付速度、限制)正是會翻轉答案的變數,不是禮貌性暖身。
觀念
steel thread 的重點在「端到端」:整條鏈的未知數在最便宜的時候先暴露;複雜度要被需求觸發,不是被預測
先講完最薄的一條線就有完整可討論的設計,之後每次加複雜度都綁在具體理由上。offset 起步再換 cursor 成本不高——可撤回決定的典型。
技巧
回答句型四句:這是我會開始的方案、為什麼符合目前需求、我接受哪些取捨、什麼情況下我會回頭重看
第四句把決定變成有觸發條件的決定,「我可能選錯」不再是弱點而是計畫的一部分。列五個方案等面試官挑的人聽起來不像能做決定。
體悟
先判斷決定可不可逆:可逆的(換分頁、換狀態庫)快速選先做;不可逆的(資料模型、跨團隊 API 契約)才慢下來比較
大部分前端架構決定其實是可逆的。

技巧
跟後端要 OpenAPI / Swagger 檔,先看契約再看實作——不懂 Java 的前端也能完全看懂 Java 後端的 API
契約(有哪些端點、進出什麼形狀)穩定、可讀、跨語言;實作才需要語言知識。不認得 swagger 會被解讀成「沒待過成熟團隊」。
觀念
REST 容易擴展的主因是無狀態,不是冪等性;冪等解的是重試安全。DELETE 冪等但不安全,GET 兩者皆是
safe = 完全不改變狀態。PUT 冪等不安全,POST 兩者皆非。面試問「哪些動詞冪等」其實在確認你分不分得清這兩個維度。
觀念
max-age 過期不代表失效,只代表要重新驗證;ETag + 304 省的是傳輸量,不是往返次數
帶 If-None-Match 去問,沒變就回無 body 的 304。真要連往返都省靠的是還沒過期的 max-age:檔名帶 hash 的給極長 max-age,HTML 入口每次驗證。
技巧
N+1 幾乎不會在開發環境出現(N=20 正常、N=5000 才炸);要監測「單次請求觸發的 DB 查詢數」是否隨資料量成長
DataLoader 不是快取:把同一個事件迴圈週期內的取值請求攢起來一次送出,不改 resolver 寫法只改打出去的時機。ORM 迴圈讀關聯也是同款問題。
觀念
SSE 就是一個一直不關閉的 HTTP 回應,反向代理、LB、CDN、驗證全照用;WebSocket 要升級協定,每層代理都得特別支援
這才是「SSE 更好擴展」的實際含義。判準:客戶端送的遠少於伺服器送的就用 SSE;低延遲雙向(協作、遊戲、語音)才 WebSocket。
觀念
JWT 的 payload 是編碼不是加密,任何人都能讀;伺服器不存狀態所以無法單獨撤銷——要短效 access + refresh token
三段 base64:header、payload、signature;伺服器只驗簽章不查 DB。「JWT 怎麼登出」面試官想聽的就是這個。controller 要薄,商業規則放 service 層才能脫離 HTTP 測試。
觀念
DTO 是讓「外部契約」與「內部模型」各自演化的閘門;前端物件直接交給 DB 模型就是 mass assignment 漏洞
順序是先 validate 再 sanitize;真正防 XSS 的關鍵在輸出時依情境轉義(HTML、屬性、JS 各不同),寫入時清洗只是輔助。
體悟
NoSQL 不是「沒有 schema」,是「schema 由讀取端負責」:關聯式寫入時就擋下,文件式等到讀取時才炸
「NoSQL 比較快」限於單一文件讀寫與水平擴展;要跨文件關聯就得在應用層自己 JOIN。判準是存取模式確定了沒。
觀念
CAP 不是三選二:分區容錯是事實不是選項;真正的選擇只在網路分區那一刻——回舊資料(AP)或拒絕回應(CP)
網路正常時一致性與可用性可以同時擁有。正確順序幾乎總是:先垂直擴展、先加快取、先修慢查詢,撐不住才動架構。
技巧
讀寫分離的坑:剛送出表單立刻讀到還沒同步的複本,使用者看到修改「不見了」;解法是寫後一小段時間強制讀 master
觀念
索引是用寫入速度換讀取速度;對欄位做運算、前綴萬用字元、跳過複合索引前面欄位都會失效,用 EXPLAIN 確認
每次 INSERT / UPDATE / DELETE 都要維護每個索引。分片:範圍分片有熱點、雜湊分片範圍查詢要問遍所有片;shard key 選錯重分片極痛。
體悟
待在能力圈裡往外推一步:那裡你有足夠的既有知識判斷自己對不對;再遠一點,連錯了都不知道
所以全片都是「回你的 codebase 找」而不是「去修一門課」:課程給的知識離邊界太遠,你沒有能驗證它的參照系。

觀念
多代理「支離破碎」的根因:每個 CLI 代理都假設獨占一個工作目錄,所以只能在分支上輪流跑
IDE 外掛綁在「一個視窗、一個工作目錄」的模型上,接了多個 AI 也只是輪流不是並行。所以編排工具的技術核心一定得先解「多個工作目錄」。
觀念
分支是「歷史線」,worktree 是「目錄」:git worktree add 讓同一個倉庫同時擁有多個工作目錄、共用 .git
不用切分支就能並行不是 Orca 的魔法,是 Git 本來就有、很少人用的功能;Orca 的貢獻是把「開 worktree → 派代理 → 收 diff」自動化。
體悟
git diff 只告訴你「改了什麼」,不告訴你「哪個比較好」;好壞仍要人跑測試、讀程式碼來判斷
觀念
CLI 代理會偵測 stdout 是不是 TTY,不是就退化成非互動模式甚至拒跑;node-pty 給的是真實偽終端,所以任何代理都能接
用管線接 stdin/stdout 會失去彩色、進度動畫、確認提示。Electron + xterm.js + node-pty 跟 VS Code 內建終端是同一套技術。
觀念
xterm.js 的 WebGL 渲染器把字元當紋理交給 GPU 畫;DOM 渲染時 N 個面板同時狂噴 log 就會卡
觀念
設計模式的原理:把點選元素的標籤、class、計算樣式、React 元件名塞進 prompt——解掉「描述不清要改哪裡」
跟 DevTools 檢查元素相同的資訊,只是自動送給代理而不是給人看。SSH 模式下 worktree 與代理都在遠端,本機只是介面。
技巧
判斷需不需要編排層只問一句:我會不會同時跑兩個以上的代理?只用一個助手就是過度工程
真正吃資源的是代理本身(每個 CLI 都是幾百 MB 的 Node 程式),Electron 只是加上去的一份 Chromium 固定成本。
體悟
審查 AI 產出的能力恰恰來自親手寫過的經驗;角色轉變是「會寫但不親手寫」,新手可能在不懂的情況下合併錯的方案
指揮官要能判斷五個方案哪個好,得看得懂 diff、想得到邊界情況、知道什麼是壞味道。
觀念
worktree 只隔離「檔案」,Computer Use 碰得到「整台電腦」:登入中的帳號、密碼管理員、其他 App——所以要沙箱
Orca 與代理的介面是終端機文字流,CLI 沒對它承諾任何穩定 API,改個提示文字整合就可能壞——這是「不自己造 AI」的代價。
體悟
Orca 卡在中立位置:模型公司彼此競爭,Claude Code 不會幫你管 Codex;中立既是價值,也是依賴風險的來源
多代理會不會成主流看兩個訊號:代理便宜到能同時跑五個嗎?各家答案越來越像的話並行比較的價值就下降。

體悟
回答問題是「有沒有這個東西」的是非題;展現思路是「什麼條件下我選它、代價是什麼」的取捨題
同一份技術清單,中階講出來像背誦,資深講出來像決策紀錄。面試官在觀察你會不會自己界定問題、主動指出方案的缺點。
技巧
micro-frontend 的門檻問題:你們是否已經因為多個團隊搶同一條發布流程而互相等待?沒有這個痛就只有成本
框線切的是團隊不是技術層級——它是組織問題的技術解法,不是效能手段。代價:共用 React 版本、跨片段路由與登入、設計系統抽共用、e2e 跨多個部署。
觀念
multi-repo 的 versioning hell:修 shared-ui 要開 PR、等發版、升版號;monorepo 一個 PR 解決
monorepo 和 micro-frontend 是兩個獨立的軸:同一份程式碼庫、各自的發布流程很常見。
觀念
module federation 的 host 建置時不打包 cart,只記 remoteEntry.js 的 URL;對方重新部署 host 就拿到新版
同一個 React.lazy 動態 import 語法,先前切自家 chunk,現在跨網路拿別人的模組。代價:URL 掛掉 host 開天窗;React 要在 shared 協調否則載兩份。
技巧
帶內容雜湊的檔名設超長快取;index.html 與 remoteEntry.js 這種「指路的檔案」設極短或不快取
否則使用者拿著舊地圖找新檔案。延遲主因是光速加 TCP / TLS 來回次數,所以縮距離的收益是成倍的。
觀念
tree shaking 靠 ES module 靜態分析;CommonJS 的 lodash 要走子路徑 import,lodash-es 才能被搖掉
import _ from 'lodash' 拉整包 70KB+,子路徑 2KB。用 bundle analyzer 查有沒有中招。
技巧
defer / async 只對外部 script 有效,寫在內嵌 script 上不生效;critical CSS 直接內嵌免首屏等外部樣式
無屬性擋住解析與繪製;defer 平行下載、解析完依序執行;async 下載完立刻執行,適合彼此無關的第三方腳本。
技巧
分 state 只問一句:這份資料的真相在伺服器上,還是只在這個瀏覽器分頁裡?前者 React Query,後者 useState
早年把 API 資料塞進 Redux,於是自己寫 loading、error、快取、race condition——這些全是 server state 特有的副本管理問題。
觀念
斷線後重播還是整份重抓,看推的是「事件」(聊天、協作編輯)還是「最新狀態」(儀表板、股價);重連要指數退避
重播需要伺服器保留事件序號與歷史;整份重抓只要重載快照。伺服器一掛,成千上萬客戶端同時重連會再打掛一次。
觀念
feature flag 讓「部署」和「發布」脫鉤,也讓獨立部署的片段能獨立回退;每個 flag 要設到期日
CI 裡加 lighthouse 效能預算,載入效能才變成會被擋下來的硬指標,否則 bundle 只會單向惡化。清不掉的舊 flag 讓程式碼難推理。
觀念
ErrorBoundary 只攔 React 渲染期的錯誤;事件處理器、非同步回呼、Promise rejection 要靠全域監聽補
每個 micro-frontend 各包一層——各片段獨立部署就必須獨立失敗。錯誤報告要帶 userId 與 route 才可能重現。
技巧
先問三件事再提方案:規模與限制(使用者、裝置、團隊、期限)、現況(技術棧、痛點)、真正要解的問題(業務指標)
沒有限制條件就沒有正確答案,先問限制不是禮貌,是取捨的前提。

體悟
「跟什麼比」指的是跟改動前的自己比——這就是 baseline;測量必須便宜到你真的會跑第二次
可比的前提:同一段程式、同一批資料、同一台機器、同一種 build。沒有 baseline 可能改到更慢卻不自知。
觀念
performance.now() 夾住的那段必須是同步的;中間有 await 或 setTimeout 就只量到「同步碼跑完」而不是「事情做完」
觀念
用 performance.now() 不用 Date.now():單調遞增、不受校時影響;解析度被刻意調粗,極短操作要跑多次取中位數
Date.now() 在 NTP 校時瞬間可能量出負值;瀏覽器因 Spectre 疑慮把時鐘解析度調粗。
技巧
mark / measure 的結果留在 performance timeline,DevTools 錄製也看得到;用完要 clearMarks
performance.now() 只活在區域變數裡。名稱字串打錯不會報錯,只會安靜少一列。看表格看比例不看絕對值:96% 落在 search 才是拆解買到的。
觀念
mark / measure 只知道「你的程式從哪一行到哪一行」,對同一段時間裡的 layout、paint 一無所知;要區分需要 profiler
同樣 200ms 可能是 JS 迴圈也可能是改 class 觸發整頁 reflow。PerformanceObserver 的 long-animation-frame 能給部分歸因,但給不出 call stack。
技巧
錄 Chrome Performance 前把 CPU throttling 調 4x–6x,否則 long task 比真實使用者樂觀得多;先按錄再互動
重跑同一個操作,新工具量的才跟 baseline 對得起來。
技巧
火焰圖先看 self time:self ≈ total 代表時間燒在這個函式自己的迴圈;self 小、total 大就該優化它呼叫的下層
Summary 裡 Scripting 壓倒 Rendering / Painting 時,還沒放大就知道不必查樣式或繪製。
觀念
baseDuration 是「假設完全沒 memo 時的估計」,跟 actualDuration 一起看才知道 memo 有沒有省到
只包在意的子樹,不 profile 整個 app;onRender 其實還有 startTime / commitTime,要對到 Chrome 時間軸時會用到。
體悟
工具的盲點是對稱的:只看 React Profiler 會說「30ms 很快沒問題」,卻不知道使用者等了 400ms;三個數字要量同一次互動才能相除
觀念
StrictMode 讓 render 跑兩次且不是穩定的兩倍(第二次快取已熱),連除以二都不可靠;profiler 數字只當相對比較
production build 關掉 Profiler 是因為每個 commit 都要記時間戳;接近正式環境要用 profiling build。React 的 Scheduler ⚛ / Components ⚛ 軌道會寫進 Chrome 時間軸。
技巧
三個工具是三種解析度,由粗到細用:先用最便宜的確認真有問題、再錄時間軸找位置、最後才進框架內部
Performance API 是你自己插的探針、Chrome Performance 是瀏覽器全景錄影、React Profiler 是一棵子樹一次 commit。找到瓶頸後每個改法都改變結構,所以都要先有 baseline。

體悟
AI 把實作時間壓到接近零,卻推高了驗證時間;架構決定 diff 的可讀性,可讀性決定你敢不敢用 AI 的產出
同一段 code 在 20 萬行單體裡要跑完整回歸,在 3,000 行邊界清楚的微前端裡讀 diff 就知道影響範圍。AI 時代的架構目標是讓系統容易被驗證。
觀念
拆微服務的驅動力是人不是技術:n 人有 n(n-1)/2 條溝通路徑,40 人就是 780 條——stand-up 一個半小時的數學原因
微服務多半讓系統更慢更貴(網路延遲、運維成本),它換到的是團隊能平行前進。
技巧
微前端的判準跟微服務一樣:你有幾個團隊在互相卡住;只有一個團隊就上,買到全部成本、沒有任何好處
三個代價:每個微前端各帶一份 React(要 Module Federation 共享)、shell 的 global state 是沒型別檢查的分散式 API、CSS 不會自動隔離。shell 是單點故障所以要極薄。
觀念
blast radius 給「小 PR」一個實質理由:不是好看,是出事時壞掉的東西少、找起來快
垂直整合的邊界:你驗證不了的領域 AI 幫不了你。廣度用來知道要問什麼、跟誰對接,深度仍要自己選一兩個方向長。
體悟
BFF 的判準是擁有權不是技術:由前端團隊部署、on-call 才算;最後還是後端在維護,你只是多了一層網路跳躍
技術上叫後端多開一個聚合端點也行,但排程仍在他們手上——BFF 的價值是把決定權搬到前端團隊。
技巧
cache busting:檔名塞內容雜湊,index.html 不快取、其餘全設一年不變,舊檔永遠不必失效
CDN 邊緣節點是 pull 模式:每區第一位使用者仍回源付完整延遲。光速是不可談判的限制,所以 CDN 是投入產出比最高的效能手段。
技巧
design system 讓 agent 從申論題變選擇題;先只做 token(顏色、間距、字體、圓角),這幾組幾乎不會猜錯
agent 不知道你的品牌色就會發明一個;有 --color-primary 和既有 <Button> 時它只需選用哪個。約束越強驗證越快。太早做元件庫是猜測,太晚要重寫。
觀念
repo 邊界和部署邊界是兩件事:monorepo 管原始碼與工具鏈,獨立部署靠 Nx / Turborepo 的依賴圖只重建受影響的
對 agent 的價值是能沿 import 路徑追蹤真實依賴、看得到誰用了這個元件;跨 repo 時它以為在做局部修改,實際動到別人的介面。
技巧
MCP UI 必須走宣告式白名單:前端先註冊元件與 props schema,LLM 只能回「元件名 + 驗證過的參數」,絕不回 HTML
讓 LLM 輸出決定畫面等於把不可信來源接到渲染路徑。第二個難題是狀態歸屬:使用者在 LLM 渲染的卡片上按了按鈕,要同時回到對話 context 與應用資料。
技巧
code splitting 三刀:先切路由、再切重量級依賴(圖表、編輯器)、最後 vendor 分離;切太碎變瀑布,要搭 prefetch
點下去才載入會把延遲從載入期搬到互動期,變成 INP 問題;閒置或 hover 時先偷偷載好。
體悟
渲染策略的判準是「這一頁的內容在什麼時候才能確定」:建置時→SSG、會過期→ISR、每人每次不同→SSR 或 CSR
同一站不同路由用不同策略是正常的。SSR 的成本不在渲染而在你多了一台要維運的伺服器;SEO 只涵蓋幾個公開頁時 SSG 幾乎總是更划算。
第 17 段 →
渲染策略:CSR、SSG、ISR、SSR
·
static site generation incremental static generation server-side rendering hydration
技巧
只有伺服器要說話用 SSE,雙方都頻繁說話才用 WebSocket;EventSource 只支援 GET,要帶 Authorization 改用 fetch
SSE 跑在普通 HTTP 上,CDN、代理、壓縮照用,內建自動重連;HTTP/1.1 每網域 6 條連線上限,幾個分頁就卡。AI 通訊不對稱,所以 LLM 應用都用它。

體悟
渲染發生在哪裡,決定了誰快、誰慢、誰耦合——整條架構演化鏈都是「把渲染搬來搬去」
MVC 的 view 在伺服器:SEO 好、首屏快、不需要前端工程師,但任何互動都得整頁重載。歷史順序不是好壞順序。
觀念
SPA 搬走的不只是渲染,還有狀態的所有權:瀏覽器養一份資料副本,快取、失效、race condition 全變前端日常
這是後來冒出那麼多狀態管理工具的原因。今天 SEO 差的理由從「搜不到」變成「慢且不可靠」(社群預覽卡片不跑 JS)。
體悟
邏輯放到 client 的那一刻就不可信任:前端的驗證、價格、權限判斷只是體驗優化,後端一定要再做一次
client 越厚版本管理越痛(使用者跑的可能是三週前的舊版);厚度可以逐畫面選,RSC 就是讓元件樹一部分 thin 一部分 thick。
觀念
BFF 是「誰擁有這層 API」的組織決策,GraphQL 是「查詢語言長什麼樣」的技術決策;兩者獨立,面試時分開講
BFF 由前端擁有意味著接下部署、監控、on-call 與資安責任,比學 GraphQL 語法貴得多。
觀念
ISR 是「先給舊的、背景更新」:踩到過期的人拿到的仍是舊頁,「改了資料庫頁面沒變」由此而來
SSG 在 build 時產生(頁數 = build 時間),ISR 移到第一個過期後的請求。兩者前提都是內容不因人而異,要個人化就得 SSR。
觀念
hydration 是為了修補「HTML 沒帶著行為」這個先天缺陷;RSC 的思路是一開始就別讓不互動的元件進客戶端的樹
實務兩個痛點:hydration mismatch(依賴時間、隨機值、window 的程式碼兩邊對不上);RSC 的代價在心智模型,跨界只能傳可序列化資料。
第 7 段 →
SSR、hydration 與 React Server Components
·
hydration React Server Components island architecture
體悟
「SSR 效能最好但擴展性最差」不矛盾:效能量單一使用者的速度,擴展性量流量成長時的成本曲線
靜態檔案曲線幾乎水平,每個請求跑一次 React 的伺服器曲線是斜的。該不該搬 Next.js 的問法:載入速度真的在傷害轉換率或排名嗎?有數據嗎?
體悟
clean architecture 在前端划不來:框架相關的程式碼本來就佔八成,換框架保住的只是幾個計算函式
真正值得留下的是依賴方向那條規則:讓不穩定的依賴穩定的——別讓資料抓取細節滲進元件、別讓 API 回應形狀直接當畫面狀態。
技巧
邊界靠自律守不住:用 lint 或 build 規則把跨領域的匯入直接擋掉,讓違規在 CI 就失敗
體悟
micro-frontend 共用得越多獨立性越假;活得下來的只共用設計代幣與少數版本化元件,寧可重複不要耦合
共用狀態把各團隊綁在同一份契約上,共用 CSS 沒有天然隔離。module federation 讓各應用共用一份 React 實例,但要求版本相容——版本協調正是這模式想消滅的。上千工程師才需要它。
技巧
面試回答一句涵蓋三層:渲染策略(SSG + SSR)、程式碼組織(模組化單體)、演化方向(評估過 micro-frontend),再補理由
「用 SSG 是因為商品頁要 SEO,個人化才用 SSR,因為不想放棄 CDN 快取」——有理由才從背下來的清單變成自己的決策。先稽核自己的 code base:在哪一站、為什麼、下一步。

觀念
Observable 的 lazy 與可取消是同一件事的兩面:subscribe 才啟動,工作才有擁有者(subscription)可以被取消
Promise 一出生就在跑、沒有擁有者,所以 AbortController 得從外面另補一條取消通道。push-based 指值由來源主動推給你。
觀念
error / complete 只要叫過一次,stream 就終止,之後的 next 一律被丟棄;值只能在 constructor 裡產生是刻意封裝
外面動不了,Observable 才能保證每次 subscribe 都重跑同一份說明書;這個限制之後由 Subject 補洞。
觀念
多條非同步來源先在宣告層併成一條 stream 再 subscribe 一次,錯誤處理與取消只需要做一次
陣列的 map 立刻算完,stream 的 map 只是宣告「以後每個進來的值都這樣處理」,真正執行要等 subscribe。
觀念
pipe 讓 operator 變成獨立函式才可能 tree shaking;掛在 prototype 上的舊寫法打包工具無從判斷哪些用得到
技巧
一般 Subject 不保存歷史,要先 subscribe 再 next;UI 幾乎總是要 BehaviorSubject——新訂閱者一接上就拿到當前值
元件掛載時就該看到現在的值,而不是等下一次變化;這是實務上最常見的 Subject 選型錯誤。
體悟
狀態住在 stream 裡而不是元件裡,元件只是這條 stream 的最後一個訂閱者——同樣 props 永遠畫出同樣畫面
受控輸入是一個完整迴路:inputValue 下去、handleChange 上來、再下去,值繞一圈才回到畫面,中間才有位置插 debounce 與驗證。
觀念
interval 永不結束,元件 unmount 後它仍每秒推值、抓著 setState 的參照;unsubscribe 不是最佳實踐,是必要動作
marble diagram 上那條豎線在不在,決定你要不要自己收尾。
技巧
要不要用 Rx 問三題:要合併多個非同步來源?要取消先前的工作?有 debounce / retry / 重播?都不是就 useState + fetch
反過來說,一旦在手寫「這個請求過期要忽略」「這個訂閱要記得清」的旗標,stream 已經在你的程式裡了,只是還沒有名字。
觀念
同源政策管的是「讀回應」,不是「發請求」;刪帳號這種做完就算數的動作,傷害在請求抵達那一刻已造成
請求照樣送出、伺服器照樣執行、cookie 照樣附帶,瀏覽器只是不把回應交給發起的頁面。同源 = 協定、網域、連接埠三者全等。
觀念
CSRF 偽造的不是內容而是意圖;目標一定是改變狀態的動作,因為攻擊者本來就讀不到回應
受害者必須在目標站已登入;攻擊者不需要知道帳密,只是借用你的瀏覽器。所以防禦不能靠「檢查請求長得對不對」。
技巧
伺服器其實看得到 Origin / Referer 標頭,只是預設不去看;後端檢查它們是 token 之外的另一條防線
CSRF 的根本問題不是「資訊不存在」而是「沒有人去驗」。SameSite cookie 2019 年後已成瀏覽器預設。
體悟
anti-CSRF token 靠的正是同源政策擋讀——同一條規則在攻擊時無害、防禦時致命;CSRF 沒有繞過同源政策
同源政策保護的是「資料」不是「動作」,CSRF 偷的是動作,兩者從頭到尾沒衝突。防線在伺服器的驗證,不在瀏覽器。
觀念
token 必須隨機且綁定 session:可預測(時間戳、序號)等於沒防護;全站共用的 token 攻擊者自己註冊就拿到
技巧
用表單拼 JSON:整段 JSON 放進 name、用未關閉的引號讓瀏覽器插的等號落進 junk 字串;enctype 必須 text/plain
不對抗限制而是把限制納入設計:「把不可控的字元吞進字串字面值」在注入類漏洞裡反覆出現。預設 urlencoded 會把大括號百分號編碼。
觀念
fetch 跨來源預設不帶 cookie,要明寫 credentials: 'include';一標上 application/json 就升級成需要預檢
主控台的同源錯誤無關緊要——失敗的只是「讀回應」,攻擊不需要那一步。但這條捷徑的短建立在「不設 Content-Type」上。
體悟
預檢是「連送都沒送」,不是「送了讀不到」;要求 Content-Type: application/json 是不用 token 的划算防線
帶 cookie 的跨來源請求還需要 Allow-Credentials: true 且 ACAO 不能是 *;把 Origin 反射回 ACAO 就是對全世界敞開大門。
體悟
漏洞組合技:Flash 能設標頭但沒身分、瀏覽器有身分但不能設標頭,用 307 轉址把兩個殘缺串成一個完整請求
307 / 308 規範上必須維持方法與 body(301/302 會降級成 GET)。Flash 已死,但「換一個不受主流安全模型管的執行環境」這個模式沒消失。
觀念
今天 CSRF 變少是框架預設防護 + SameSite 預設;縫在 SameSite=None、GET 改狀態、子網域之間、CORS 設錯
有防護不等於安全:token 從別的端點外洩、或 token 可預測,任一成立防線就垮。

觀念
三個指標的時間窗不同:LCP 是時間點(首次互動後凍結)、CLS 是累加值、INP 沒有互動就不存在
所以 DevTools 上 INP 顯示一橫槓不是頁面快,是還沒人按過。
觀念
阻塞腳本傷 LCP 的真正原因:佔住主執行緒沒人能畫圖、而且跟圖片搶頻寬;圖片請求其實早就發了
preload scanner 在 parser 被卡住時已把 <img src> 請求發出去;LCP 記的是「畫完」不是「下載完」。所以修法要同時動 defer 和 preload。
觀念
defer 安全的來源是時機(解析完才跑),不是腳本不改 DOM;async 下載完就插隊執行、不保證順序
defer 保證在解析後、DOMContentLoaded 前、多支維持書寫順序,適合有相依的應用碼;async 適合獨立的分析腳本。
技巧
preload 管「何時開始下載」、fetchpriority="high" 管「搶頻寬時排第幾」,一個管時間一個管順位,一起用
觀念
CLS 豁免使用者互動後 500ms 內的位移;每次分數 = 受影響面積佔視窗比 × 移動距離佔視窗比
所以「先讓使用者按了才長出來」是合法策略;分母是視窗,視窗縮小同一次位移罰得更重。現在用 session window 取最高的一段。
技巧
img 寫上 width / height 後瀏覽器換算成 aspect-ratio,CSS 照樣可以 width:100%; height:auto
「寫死寬高會壞 RWD」2019 年後已不成立。長寬比真的未知時,容器直接寫 CSS aspect-ratio 或固定高度骨架。慢不會造成位移,資訊不足才會。
觀念
INP 取整次造訪近乎最差的一次互動;把重運算包進 async/await 沒用,它仍在同一條主執行緒排隊
單次互動延遲 = input delay + processing time + presentation delay;長工作放大的是頭尾兩段,所以修法是切開讓出時間而不是把運算寫快。
技巧
先改按鈕文字,再用 setTimeout 包住第一塊工作,瀏覽器才畫得出「處理中」;每塊 setTimeout 0 是排到隊尾
少了那層包裝,同步設完文字緊接著開跑,畫面從 Process Data 直接跳 Done!。不碰 DOM 的運算更該丟 Web Worker。
體悟
本機 Local metrics 只能做 before / after 相對比較;Google 合格看的是 CrUX 28 天 75 百分位的真實使用者資料
三個病灶同一句話:瀏覽器需要的資訊或時間被別的東西佔走——繪製時機被腳本佔、排版尺寸缺席、執行緒時間被長工作佔。

觀念
401 Unauthorized 其實是「還沒認證」,403 Forbidden 才是「認證過但沒權限」——連規格自己都混淆
兩個字都縮寫成 auth、常塞進同一個 middleware;看別人的 API 時別被 401 的名稱誤導。
觀念
發 token 的重點是把長期祕密(密碼)換成短期憑據,讓外洩的損害有時間上限
token 上編碼的欄位叫 claims:sub 是誰、exp 何時到期、roles 角色;後面所有權限判斷讀的就是這些。
觀念
只有認證沒有授權的典型漏洞是 IDOR:把 /invoices/1001 改成 1002 就看到別人的帳單
攻擊者合法登入、token 有效、每次請求都通過認證,但拿到不屬於他的東西——授權要防的是內部人。
體悟
授權是每扇門各判各的;讀卡機亮紅燈是「沒看到允許依據」而不是「看到禁止規則」=預設拒絕
判斷發生在主體帶來的角色與客體要求的角色相遇那一刻,所以不能只在入口做一次。漏寫一條規則的後果應該是打不開門。
技巧
授權不能只寫在前端(藏按鈕)或只在 gateway 做一次;檢查點要落在最接近資料的那一層
藏按鈕的畫面看起來對了,但 API 照收請求、curl 就繞過;只信任入口,一個入口被繞過就全面失守。認證一 session 一次、授權每次存取都做。
觀念
permission 隨功能長、role 隨組織長;中間隔一層 role,「新功能」和「新同事」就不互相干擾
新功能只需決定掛進哪些角色,新同事只需指派角色。role 給人看(你是哪類人),permission 給資源看(可以做哪件事)。
技巧
新角色從零權限逐項加,不要從管理員複製再刪;出現「只看自己部門」這種條件時該換模型,不是再切角色
從管理員複製幾乎必留多餘權限;「北區付款管理員」「南區…」是角色爆炸,該換成 ABAC。
體悟
認證可以外包(Auth0)因為每家需求幾乎一樣;授權規則來自你的業務,沒有服務能替你決定
認證的難處是密碼雜湊、暴力破解、MFA、帳號復原這些跟業務無關卻極易做錯的細節;外部服務只能提供承載規則的機制。

觀念
innerHTML 會解析 HTML、textContent 不會;把使用者文字餵給 innerHTML 就是把資料當程式
這一行 div.innerHTML = comment.text 是整個 stored XSS 的根。人會忘記,所以防禦不能建立在「開發者永遠不犯錯」上。
觀念
三種 XSS 差在注入路徑:stored 存在 server、reflected 由 URL 回顯、DOM-based 全在瀏覽器端
DOM-based 是前端 JS 自己把 location.hash 寫進 DOM,server 從頭到尾沒碰過 payload。
體悟
CSP 把防禦從「不讓壞東西進來」改成「就算進來了也跑不了」;兩者是兩層,不衝突
CSP 是 server 告訴瀏覽器的規則,由瀏覽器執行,不是 server 自己做的過濾。嚴格政策還會擋 inline script 與 eval。
技巧
能用 header 就用 header:meta 版少了 frame-ancestors、report-uri、sandbox,且 meta 之前的內容不受保護
語法是「directive 空格 value;」不是 JS 的 key: value。另有 Content-Security-Policy-Report-Only 只回報不阻擋。
觀念
default-src 只是 fetch 類 directive 的預設;frame-ancestors、form-action、base-uri 要另外寫
像 switch 的 default 分支:找不到資源類型對應的 directive 才用它。'self' 要加單引號,指同 scheme/host/port。
技巧
導入 CSP 先開 Report-Only 觀察哪些合法資源被誤擋,再切成強制;inline script 改 nonce 或抽成外部檔
SPA 的主要阻力是打包工具產生的 inline script / style(webpack runtime、CSS-in-JS);Next.js、Angular 已內建 nonce 支援。
觀念
CSP 管「頁面內子資源用什麼協定載入」,HSTS 管「以後連這個網域一律 https」;第一次 http 載入 CSP 擋不了
upgrade-insecure-requests 把子資源 http 自動改 https;這其實防的是中間人竊聽竄改,不是 XSS。
體悟
「有 CSP 就防大多數 XSS」的前提是政策夠嚴:沒有 'unsafe-inline'、白名單裡沒有可被利用的 CDN
寬鬆的 CSP 防不了什麼;'strict-dynamic' 可以省掉維護 origin 白名單。

觀念
快取是否過期是拿 age 比 max-age;immutable 加檔名內容雜湊,靜態檔就能放心設一年
檔案變了就換 URL,所以快取可以極長;age 由 CDN 回報「這份在快取裡待了多久」。
觀念
憑證只證明「這把公鑰屬於這個網域」,真正保護後續流量的是交握換來的對稱金鑰
HTTPS 給兩件事:機密性來自加密、身分可信來自憑證鏈;自簽憑證有前者沒後者。TLS 1.3 已壓到 1-RTT。
觀念
polling → SSE → WebSocket 是「浪費 → 單向自動重連 → 雙向自己管狀態」的梯度
SSE 自帶 id / retry,斷線後瀏覽器帶 Last-Event-ID 續傳;LLM 逐 token 串流正好是單向,所以 AI 應用幾乎都用 SSE。
觀念
PUT 冪等、「數量加一」式的 PATCH 不冪等;客戶端會自動重試時這是正確性問題
同一個請求送一次和送十次最終狀態相同才叫冪等,這是 POST 之外還需要其他動詞的理由。
體悟
under-fetching 與 over-fetching 的共同根源是「欄位由誰決定」,不是效能問題
認清是控制權問題,才理解為什麼下一步要換一整層(GraphQL)而不是再開一個 /mobile-list 端點。
技巧
DataLoader 以請求為單位:每個請求 new 一個;跨請求共用會讓使用者看到別人的舊資料
它靠事件迴圈一個 tick 收集所有 .load(id),合併成一次 WHERE id IN (...)。N+1 也是 ORM lazy loading 的同款問題。
體悟
BFF 只做聚合與裁剪、不放商業規則;每多一個 BFF 就多一個要部署、監控、值班的服務
訂價或庫存邏輯一寫進 BFF,剛拆開的耦合就搬回前端團隊身上。自主權有價碼。
觀念
水平擴展的前提是實例無狀態;session 放記憶體,使用者換一台就等於登出
解法是 sticky session(分流不均)或 session 外置到 Redis;LB 自己也是單點,交給託管服務跨可用區。

體悟
判斷一項技能會不會被 AI 吃掉:看它的成功條件能不能寫清楚
design→code、效能(Core Web Vitals)、測試(覆蓋率)都寫得清楚所以被塗灰;邊界、code quality、狀態設計寫不清楚。
觀念
模組邊界清楚,agent 改一個功能要讀進 context 的程式碼就少;架構品質變成每天結帳的 token 成本
纏成一團的 codebase 逼 agent 讀整片檔案才敢動手,token 多、幻覺也多。
體悟
好架構是穿過所有功能的迴歸線;AI 為單一 prompt 最佳化,等於對一個點過擬合
所以 AI 的產出「當下看起來很合理」——它確實對那一點做了最佳解,代價是推翻你之前的決定。
體悟
效能工作診斷佔 5%、實作佔 90%;被自動化的是那 90%,留下的是判斷「這是架構問題還是最佳化問題」
技巧
審 AI 產出先抓 className 裡混進的寫死值:text-2xl 旁邊突然冒出 text-[28px]
不能隨裝置縮放、跟其他頁面不一致;一致性重要是因為使用者的認知負荷,不是潔癖。
觀念
AI 重複造輪子是因為 context window 限制視野;把共用的抽成 library,讓它不必讀完全世界也找得到
React 裡把元件定義在另一個元件內部,每次 render 產生新元件型別,子樹會被卸載重建、狀態丟失。
技巧
對每一個 state 問「能不能由別的 state 推出來」,能就刪掉改成計算
畢卡索公牛:找出不能再少的那組線;同一份資料只存一次,兩份就一定有不同步的那天。
技巧
每次和 agent 做完事,親自打開 pull request 做真正的 code review
不可能讀完每一行,但必須真的嘗過:邊界告訴你看哪裡、code smell 告訴你看什麼、靜態分析告訴你漏了多少。

觀念
一次 tick 只取一個 macro-task,但 micro-task queue 會整個清空,期間新加的也在同一輪吃掉
所以無限產生 micro-task 會讓畫面卡死,無限的 setTimeout 不會。event listener 與 timer 進 macro,Promise 進 micro。
技巧
推 console.log 順序分三個時間點:建立(同步跑)、排隊(進哪個佇列)、執行(call stack 清空後)
new Promise 的執行器同步跑、resolve 只是把 .then 丟進 micro-task;setTimeout 0 改成 1000 答案不變,考的是佇列優先權。
觀念
「大括號就是 scope」只對 let / const 成立;var 只認 function scope
內層 scope 是外層的延伸不是複本:讀到的是外層變數當下的值,不是宣告時的快照。
技巧
找記憶體洩漏:從永生的根(DOM handler、沒清的 timer)往外追引用鏈,追不到的才可回收
忘了 removeEventListener、沒 clearInterval、閉包抓著大物件,都是「一個永生的根抓著一條你沒注意到的鏈」。
觀念
Promise 是控制權反轉:規格保證只決議一次、callback 必定非同步、錯誤沿鏈傳到一個 .catch
callback hell 難除錯的根因是錯誤沒有統一路徑,每層都得自己 if (err),漏一層就靜默失敗。
觀念
await 之前的部分同步執行,await 之後的程式碼永遠在下一個 micro-task 才跑
await 把右邊包成 Promise、函式暫停交回 call stack,決議後剩下的本體當一個 micro-task 排隊。
技巧
彼此無關的 await 一行行排下來等於序列化;改成 await Promise.all([...]) 三秒變一秒
async/await 讓程式碼看起來像同步,也讓人不小心真的寫成同步。
觀念
generator 保存的是整個 execution context(執行到哪一行);每個 await 大致對應一個 yield
closure 記住外層變數,generator 更進一步記住自己執行到哪。這也是 async/await 能用 Babel + regenerator 在舊瀏覽器跑的原因。

觀念
困惑是大腦在替新資料找位置的症狀;完全不困惑代表大腦根本沒在整理
「症狀」是儀表不是目標:不是越困惑越好,而是可以拿它讀出自己有沒有在連結資料點。
體悟
情緒層的困惑什麼都做不了;警探能破案是因為他在對每條線索問「這跟那個怎麼連」
多數人的時間浪費在把困惑停在情緒層;操作層的困惑才是可以行動的。
技巧
一感到困惑就寫下「哪些問題有了答案我會比較不困惑」,列成清單,逐一回答
篩選條件就是困惑感本身:困惑指向缺口,問句把缺口寫成可行動的形式。寫的當下大腦就已在歸位。
技巧
讀文件毫無困惑是紅旗;問「這對我的工作有什麼影響」把資料放回脈絡,困惑就會冒出來
不困惑是因為資料沒有目的地、大腦不必歸位;指定目的地(現有 workflow)後才需要比對、才會發現對不上。
技巧
問題清單每一條都要能回溯到一團具體困惑:像另一個 library→比較、說有好處→好處、不知怎麼放→實作/挑戰
「有沒有 use case」對應的是「無法想像它長什麼樣」這種困惑;問句的粒度隨困惑種類調整。
第 4 段 →
範例:讀新 library 的文件
觀念
體悟
多數人的瓶頸不是讀不懂或找答案慢,而是不知道自己需要哪些答案;硬讀更多只會從困惑升級成 overwhelmed
困惑 = 有幾個點還沒連;overwhelmed = 點多到不知道從哪條線開始,而後者是自己讀出來的。
體悟
embrace/trigger/turn into questions 是所有學習策略底下的共同結構;學習效率是 bang for buck,不是工具多精緻
費曼技巧用「解釋不出來」、active recall 用「想不起來」當困惑訊號,核心動作同構。

觀念
所有前端效能技巧都掛在同一條 critical rendering path 上:先有這張圖,才知道每個優化動的是哪一段
server → HTML → CSS/JS/fonts → CSSOM/DOM → render tree → 四步渲染;head 裡的資源會擋住渲染。
觀念
LCP/INP/CLS 各量到渲染路徑的不同位置,所以一個數字不夠、也各自對應不同的解法
LCP = 最大元素出現的時刻;CLS = 持續渲染時版面被推動;INP = 互動後重繪多久。
體悟
HTTP 快取只是 memoization 在檔案層的特例,多了一個 TTL;同一個模式在程式、資料庫、檔案各層都成立
技巧
要延後載入 JS,把 static import 改成 dynamic import
static import 在 build time 就進主 bundle、擋在渲染路徑上;dynamic import 才會被切成獨立 chunk,捲到/點到才載。
技巧
CSS 不能像 JS 一樣 async:只內聯首屏需要的 critical CSS,其餘延後載入
瀏覽器無法預知哪條規則影響第一個元素,所以必須把 CSS 全算完才敢畫;用 headless browser 找出首屏用到的規則。
技巧
設計狀態時只留無法推導的 essential state,其餘全部即時算出來,不要把畫面上每個數字都存成狀態
觀念
INP 慢多半是重繪太慢;無限捲動的清單用 windowing 只畫可視區,DOM 節點數壓下來就好了
觀念
能不能當 server component:看它有沒有監聽事件、有沒有狀態;全是否就只送 markup、零 JS
體悟
量測指向瓶頸 → 瓶頸指向優化 → 優化到極限就改架構 → 架構改完再改組織
micro frontends 優化的是團隊獨立部署與開發速度,不是執行效能(反而稍慢)。